lightseekorg/tokenspeed 是这周 GitHub 上另一类项目:MIT 许可、2,814 星、55MB 代码包,10 月刚被 PyTorch 基金会写进生态图谱。
它的定位是"为 agent 负载设计的光速推理引擎",目标是把 TensorRT-LLM 的性能和 vLLM 的易用性放在一起。
对多数办公团队来说,这个项目的正确用法是:知道它存在,然后继续调 API。
【一、它解决的是一层很靠下的问题】
推理引擎管的是模型跑起来之后的事:请求怎么排队、KV 缓存怎么分配、算子怎么调度、显存怎么复用。
它不管的事同样清楚:模型选哪个、提示词怎么写、权限怎么分、账单怎么算。
README 把三个核心部件列了出来:
部件:调度器;实现:C++ 控制面 + Python 执行面;作用:请求生命周期、KV 缓存归属、时序重叠,编成有限状态机
部件:算子;实现:可插拔分层内核系统;作用:统一 API + 集中注册表,含 Blackwell 上的 MLA 实现
部件:入口;实现:Rust 侧经 msgpack 通信;作用:SMG 与 Dynamo 驱动,请求路径上没有 Python
这套设计里最值得注意的一句来自 PyTorch 基金会的评述:它把控制面和执行面分开,控制面用 C++ 写成有限状态机,借助类型系统在编译期强制资源管理安全。
编译期保证代替运行时检查,代价是改一处要重编译,收益是并发下的状态不会乱。
二、装它需要什么
官方入门文档把前置条件写得没有余地:
条件:硬件;要求:NVIDIA GPU 主机,或 ROCm 7.2 的 AMD GPU 主机
条件:容器;要求:支持 GPU 的 Docker
条件:共享内存;要求:足够模型服务使用,示例给的是 32GB
条件:运行参数;要求:--privileged、--ipc=host、--network=host、--pid=host
条件:Python;要求:3.11 到 3.13,CUDA 13 环境
条件:权重;要求:自行准备要服务的模型检查点
启动容器那条命令里,特权模式与宿主网络同时打开。这是推理引擎的常规做法,因为它需要直接访问 GPU 设备与高速网络。代价是这个容器在宿主机上几乎不受限。
对一个只想让员工用上 AI 的团队来说,这条路的前提是:你有 GPU 机器、有能维护 CUDA 与 ROCm 环境的人、有模型权重、有压测能力。
四样缺一样,自建就不成立。
【三、它宣传的性能数字怎么看】
README 里列了一串新闻,都是合作方发布的:
时间:2026-10;内容:Qwen3.8-Flash-Next 在 GB300 上每用户 685 tokens/s;出处:LightSeek 博客
时间:2026-10;内容:501B MoE 以 NVFP4 跑在 GB200 上;出处:Reflection 博客
时间:2026-10;内容:Kimi K3 在 AMD MI355X 上优化;出处:AMD 技术文章
时间:2026-08;内容:Qwen3.8 2.4T 规模在 Day 0 支持;出处:LightSeek 博客
时间:2026-05;内容:Qwen3.5-397B-A17B 达到 580 TPS;出处:PyTorch 博客
读这张表需要三层折扣:
第一层,这些数字全部来自厂商或合作方,测试条件由发布方设定。第二层,硬件是 GB200、GB300、MI355X 这类旗舰卡,与办公场景常见的推理卡不在一个量级。第三层,"每用户 tokens/s"和"总 TPS"是两个口径,混着看会得出矛盾结论。
它们的价值在于证明引擎能跑通这些模型,不在给出你可预期的性能。
【四、办公团队真正该做的三层选择】
把这件事拆开,其实只有三个选项:
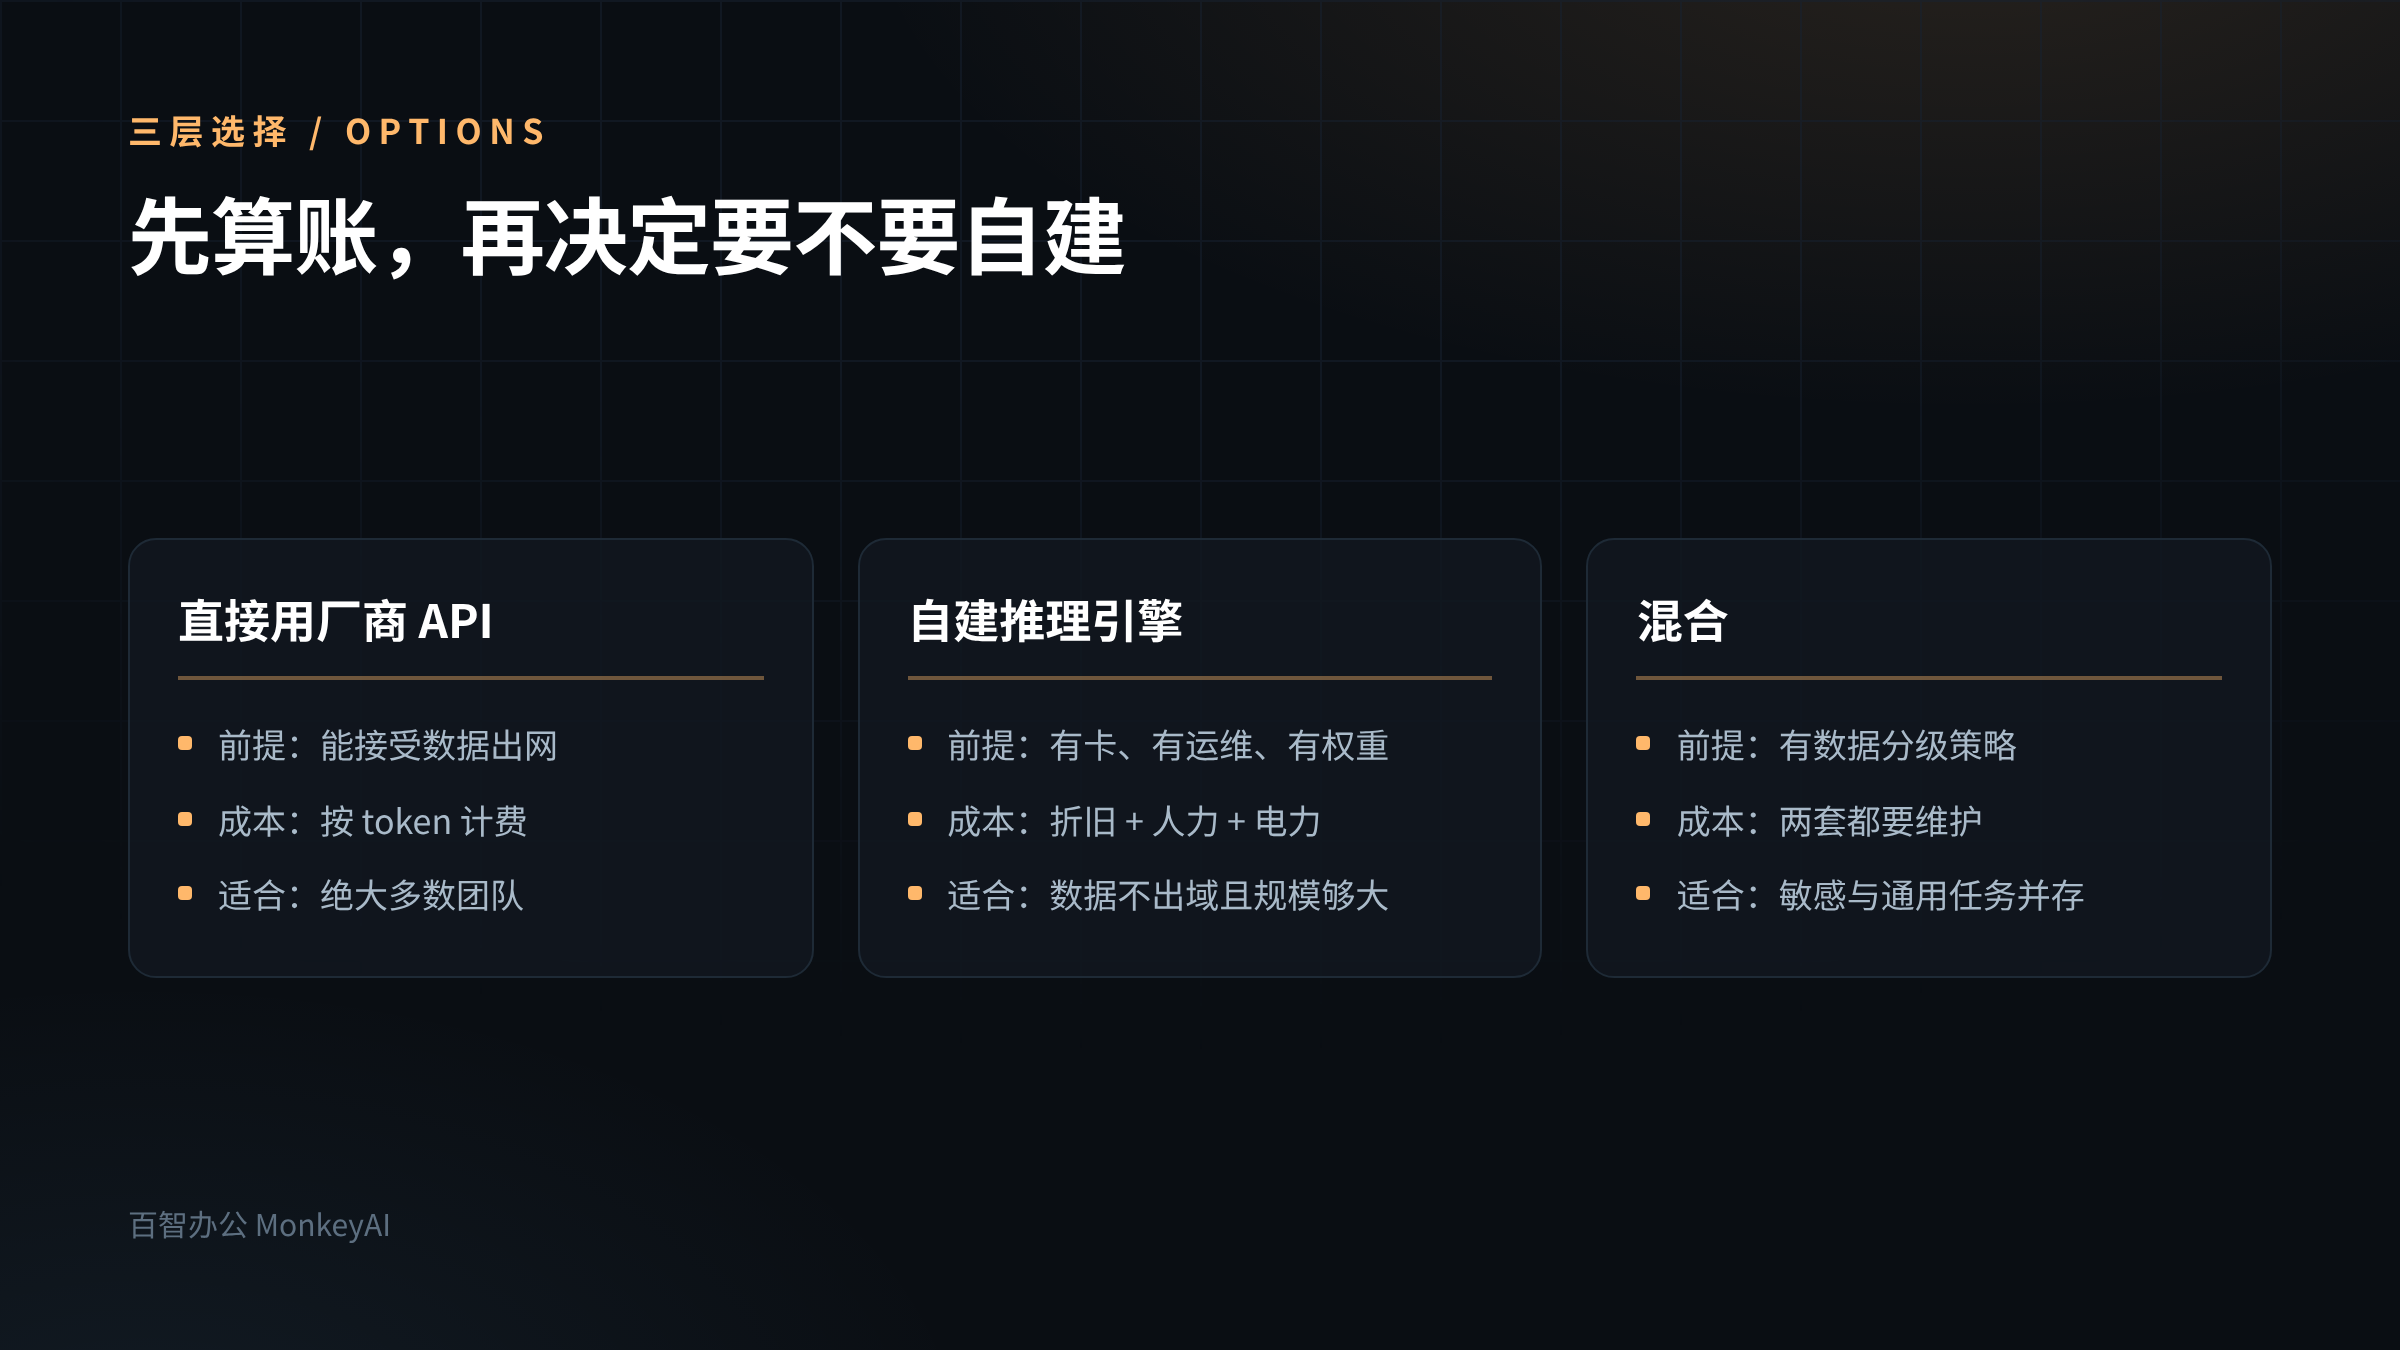
选项:直接用模型厂商 API;前提:能接受数据出网;适合谁:绝大多数团队
选项:自建推理引擎;前提:有 GPU、有运维、有权重;适合谁:有明确数据不出域要求且规模够大
选项:混合;前提:敏感任务本地、其余走 API;适合谁:有分级数据策略的团队
第二项才是 tokenspeed 这类项目的位置。它对标的是 vLLM 与 TensorRT-LLM,服务的对象是自己有卡、自己压测、自己调算子的团队。
很多团队跳过这个判断,直接问"要不要自建"。正确顺序是先算三笔账:GPU 折旧、运维人力、模型更新频率。三笔账里任何一笔说不清,就还没到自建阶段。
五、在百智办公里怎么落
百智办公把"用模型"和"跑模型"分开,正好对应上面第一和第三个选项。
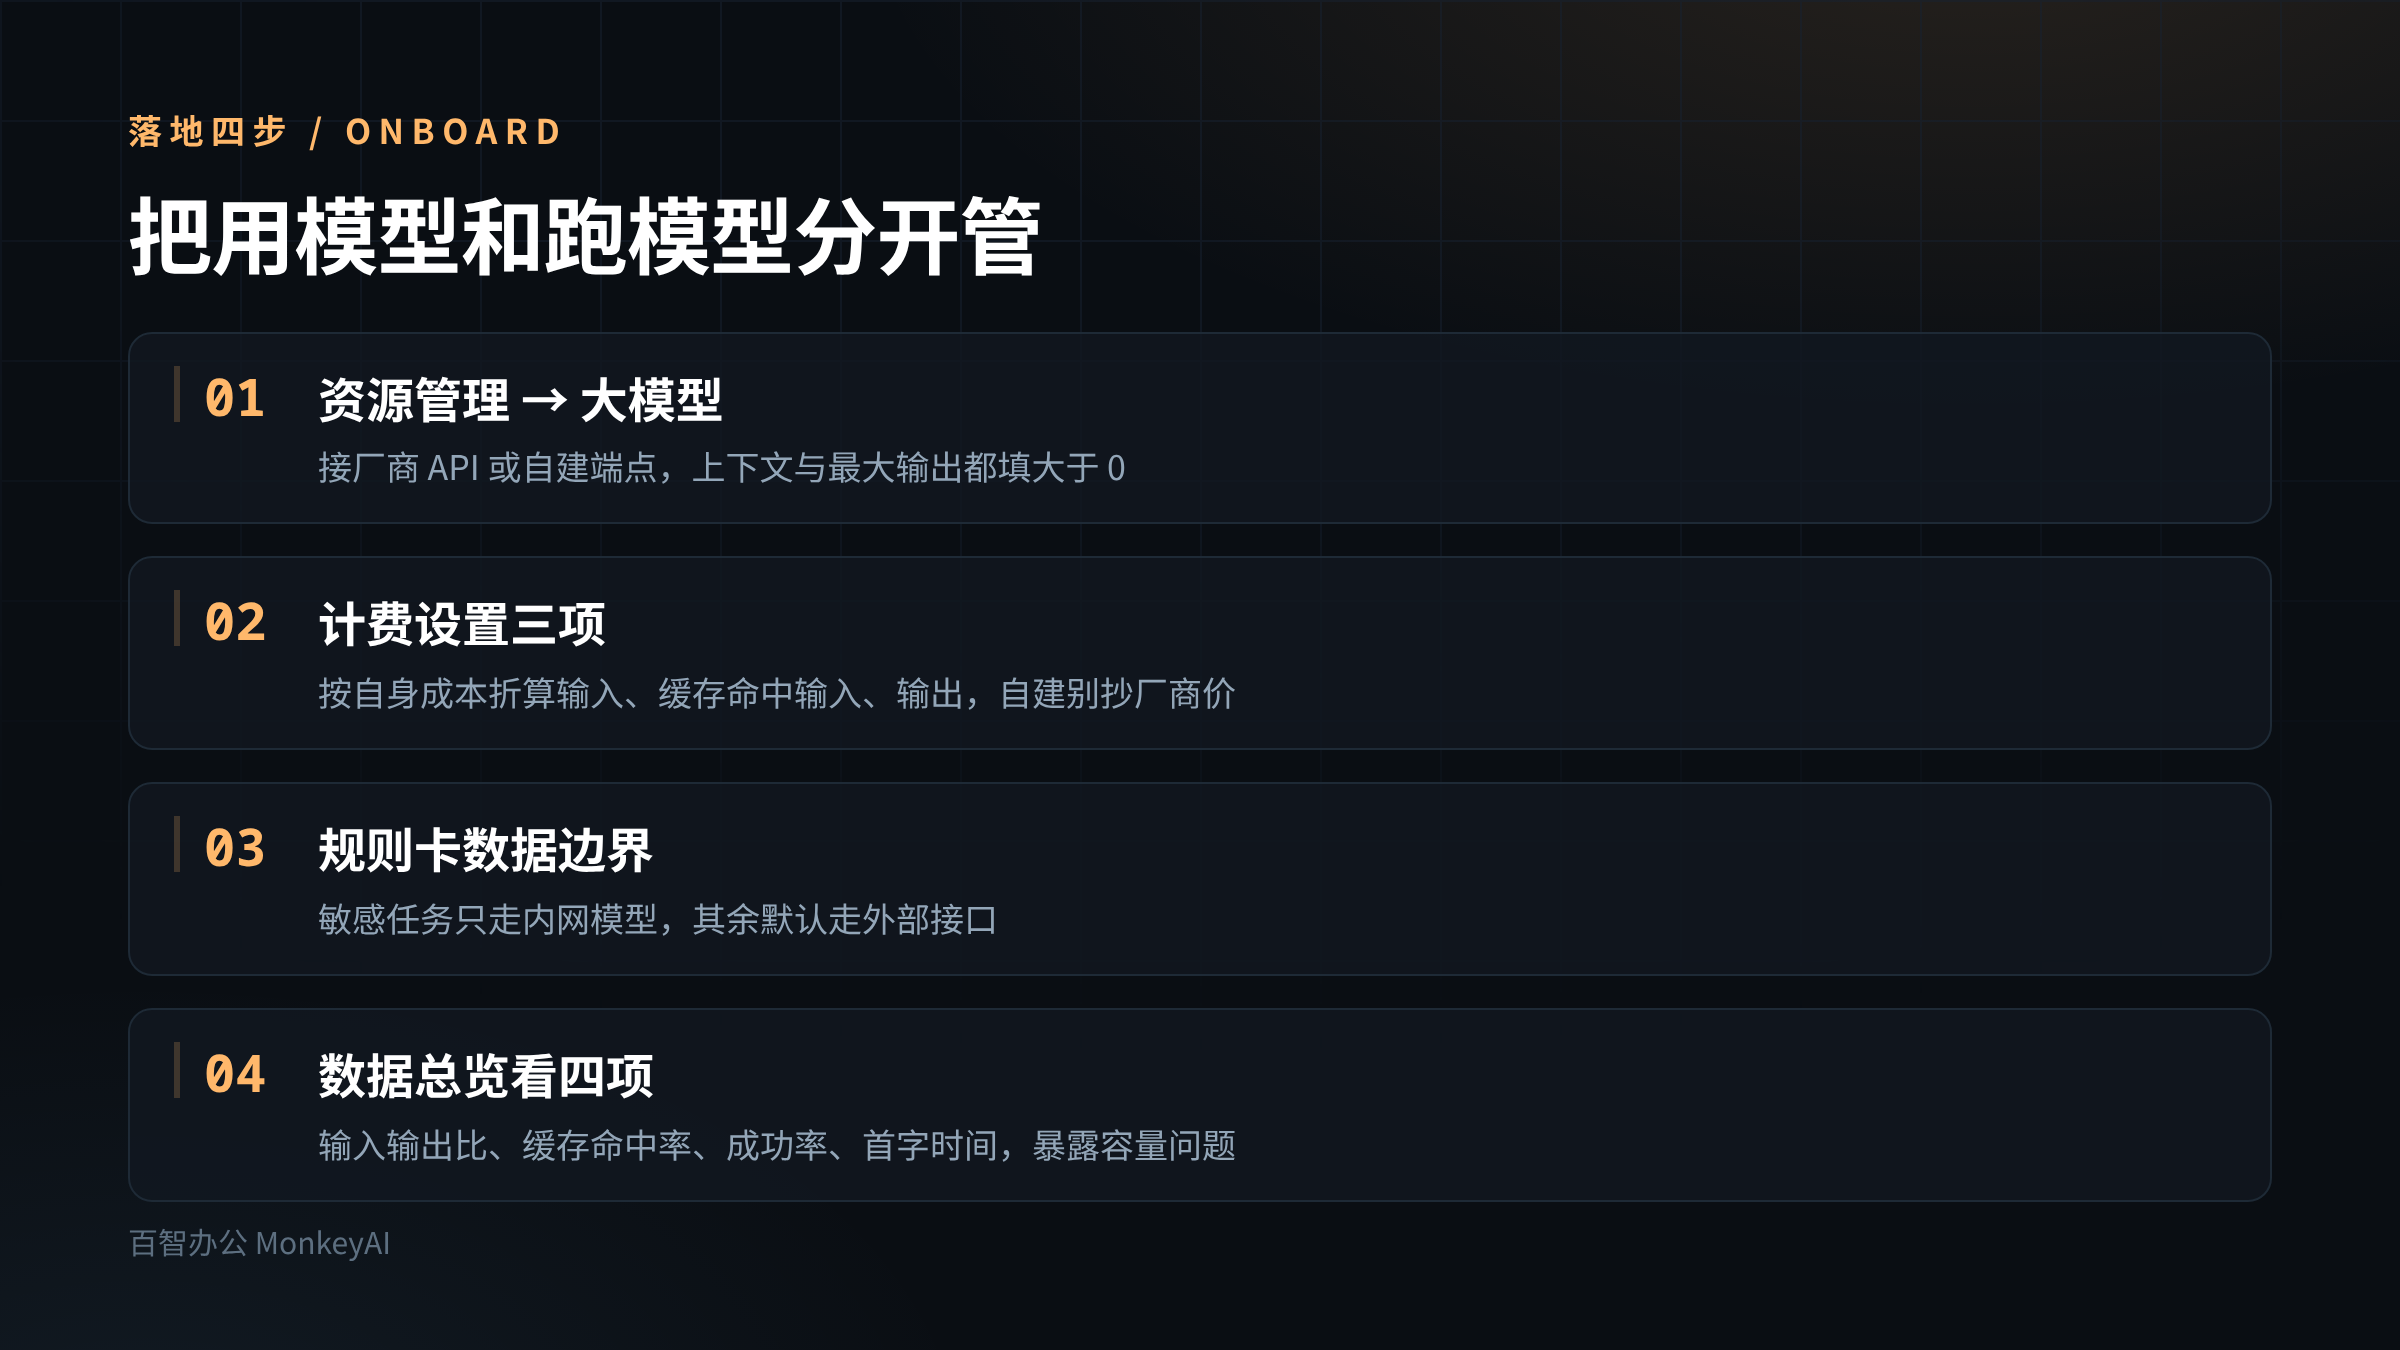
- 「资源管理 → 大模型」新增供应商:填接口地址、密钥、模型名,上下文长度与最大输出两项都填大于 0 的值。走厂商 API 的团队到这里就结束了。
- 如果自建了推理服务,同样在「资源管理 → 大模型」里新增一条,接口地址填你的服务端点。多数自建服务提供 OpenAI 兼容接口,改地址即可。
- 「计费设置」按实际成本填三项价格:输入、缓存命中输入、输出。自建时这三项按自己的 GPU 成本折算,别直接抄厂商价。
- 「资源管理 → 规则」加一条:涉及敏感数据的任务只允许走内网模型,其余默认走外部 API。这条把"混合"策略落成了可执行判断。
- 「数据总览」看四项:输入输出比、缓存命中率、成功率、首字时间。自建服务的首字时间波动通常比厂商 API 大,这一项最能暴露容量问题。
- 分发范围按分组下发:研发组可以用本地模型,行政与市场组用外部 API。
第 3 步最容易做错。自建模型时把自己的电价、卡时、闲置率算成单价,比"参考某厂商定价"可靠。
六、可以直接抄的提示词
你在帮我判断:这件事该直接调 API,还是自建推理服务。请按四问回答,每问给出结论和依据。
第一问:数据
· 要处理的文本里有没有不能出内网的内容?举具体例子。
· 如果有,是全部不能出,还是只有部分字段不能出?
第二问:规模
· 日均请求数与日均 token 量大约是多少?
· 高峰集中在哪些时段,峰值是均值的几倍?
第三问:能力
· 需要的能力里,哪些是通用模型就够的(写作、摘要、抽取)?
· 哪些需要专门的微调或私有模型?
第四问:成本
· 自建的固定成本:GPU 折旧、机房、运维人力,按月折算。
· 自建的变动成本:电力与闲置浪费。
· 直接调 API 的预估月支出。
· 给出两边的盈亏平衡点(月 token 量)。
硬性要求:
- 只依据我提供的数据,缺的写"未提供"。
- 不要给"建议自建以掌握主动权"这类结论,只给数字对比。
- 第四问算不出来时,明确说"缺少哪几项数据导致无法计算"。
- 最后一行写:本判断仅覆盖成本与合规,未考虑团队技术储备。
第四问的盈亏平衡点是全篇的核心。多数"要不要自建"的争论卡在感觉上,算出一个数字就结束了。
七、四个坑
坑一:把推理引擎当部署方案。
它能让你把模型跑起来,但账号、权限、计费、审计一件都不管。这些是工作台的活。
坑二:拿旗舰卡的数字估自己的容量。
README 里的性能数据来自 GB200、GB300、MI355X。用消费级或低端推理卡按比例折算,得到的结论通常偏乐观。
坑三:忽略特权容器的安全含义。
启动命令带 --privileged 与宿主网络。这在专用 GPU 机器上可接受,在混跑的办公服务器上是隐患。
坑四:忘了模型权重自己准备。
文档写的是"要有权访问你打算服务的模型检查点"。权重从哪来、许可怎么算、更新怎么跟,都是额外工作。
八、边界
· 2,814 星、MIT 许可:GitHub 仓库页面与仓库 LICENSE,2026-10-27 读取。星数会变,引用需带日期。
· 55MB 代码包、2,343 个 Python 文件、173 个 CUDA / C++ 头文件、73 份 Markdown:本地解包统计,2026-10-27。
· 控制面 C++ 有限状态机、执行面 Python、算子可插拔注册表、入口无 Python:仓库 README.md 与 PyTorch 基金会评述引文,2026-10-27。
· 硬件与运行前置条件、32GB 共享内存、特权模式、Python 3.11–3.13、CUDA 13:docs/guides/getting-started.md,2026-10-27。
· 五条性能与适配新闻及其出处:仓库 README.md 的 News 一节,2026-10-27。这些是发布方口径,本文未复现。
· 我没有 GPU 环境,未部署 TokenSpeed,也未做任何压测;本文的性能讨论只转述官方 README 的引用。
九、事实来源
· 星数、许可、仓库描述:GitHub 仓库页面 lightseekorg/tokenspeed 与 LICENSE,2026-10-27
· 项目定位、三个核心部件、README 中的 PyTorch 基金会评述引文:仓库 README.md,2026-10-27
· 前置条件、容器启动参数、nightly 安装方式、ROCm 7.2 路径:docs/guides/getting-started.md,2026-10-27
· 五条适配与性能新闻:仓库 README.md News 一节,2026-10-27
· 大模型接入配置与两项上限、计费三项价格、规则、数据总览四项指标、三档分发:官方文档《团队资源配置与分发》《计费与额度管理》,2026-10-27 核对