mksglu/context-mode 在 GitHub 上有 32,629 星,许可用 Elastic License 2.0。它是一款 MCP 服务,解决 Agent 的一个具体病:工具调用把原始数据灌进上下文窗口。
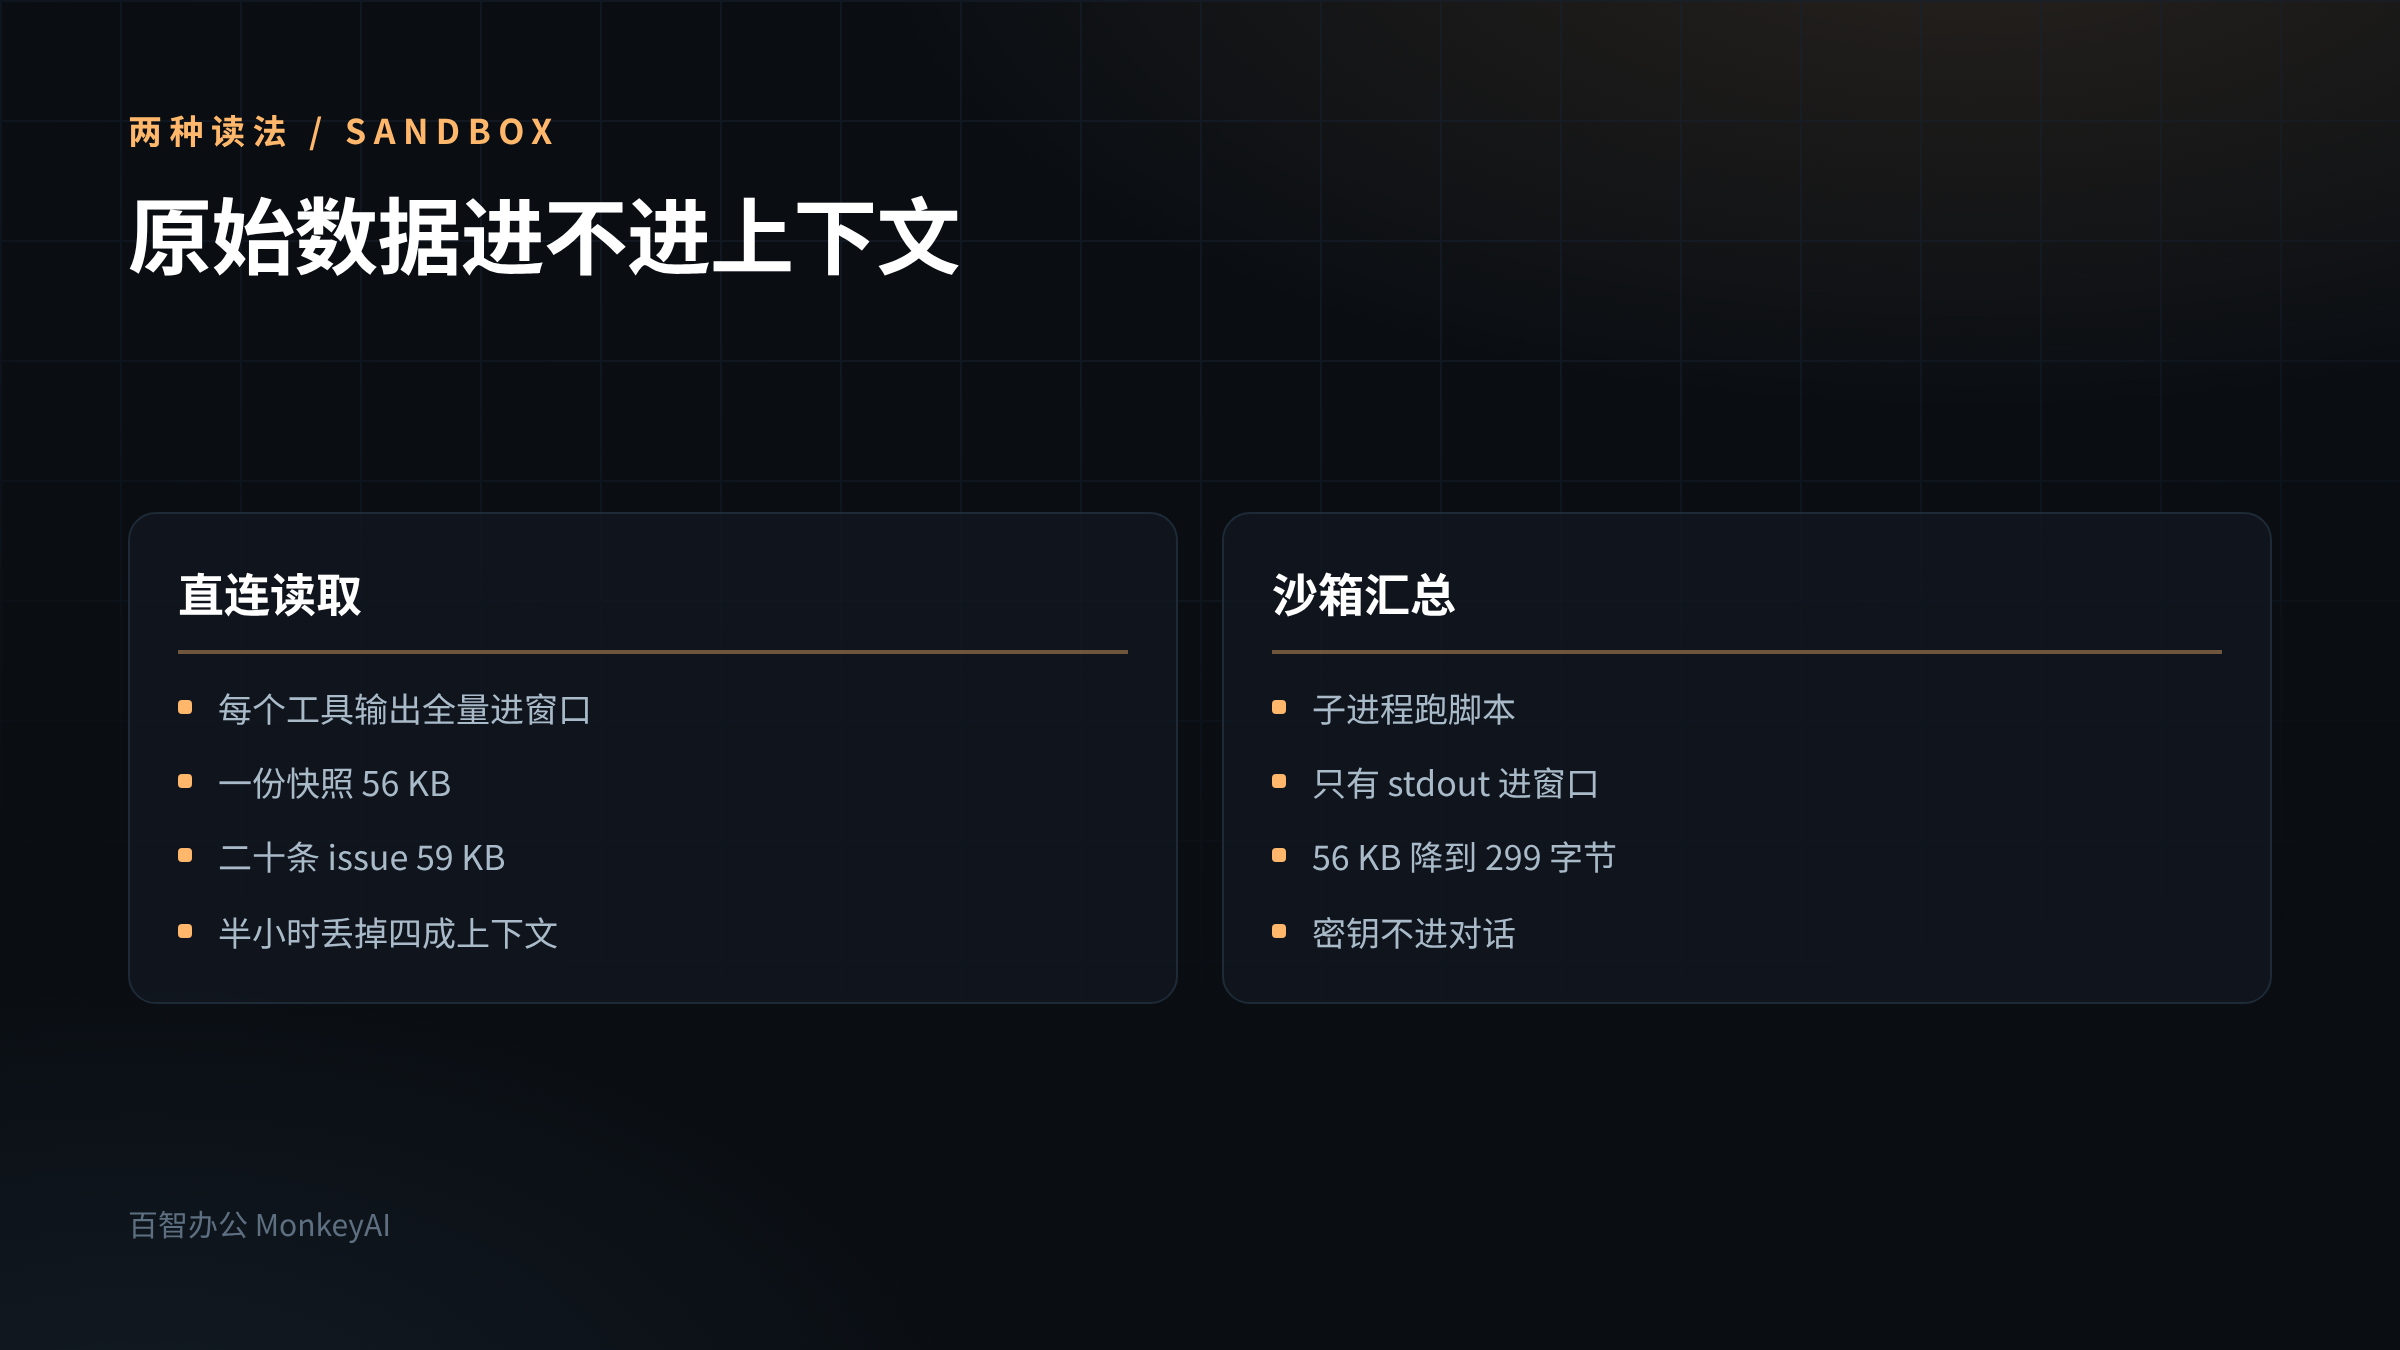
README 举了三个数字:一份 Playwright 快照 56 KB,二十条 GitHub issue 59 KB,一份访问日志 45 KB。三十分钟下来,四成上下文没了。
它的办法是把这些数据挡在沙箱里,只有脚本打印的那几行进上下文。
【一、四个数字说明了问题规模】
场景:Playwright 快照;数据量:56 KB
场景:二十条 GitHub issue;数据量:59 KB
场景:一份访问日志;数据量:45 KB
场景:汇总后的结果;数据量:315 KB → 5.4 KB
第四行的 98% 降幅是它自己算的。工具表里给的单次例子更具体:ctx_execute 从 56 KB 降到 299 字节,ctx_execute_file 从 45 KB 降到 155 字节。
这些数字的口径是"原始数据量与进入上下文的量之比",对应的是传输量。把它当成上下文窗口占用率会得出错误结论。
【二、"让模型写代码"这条主张】
README 的第二条主张是"在代码里思考"。
原文的意思是:模型该编程做分析,把计算交给脚本。读 50 个文件数函数有多少个,不如写个脚本数完 console.log 结果。
它给了对照:47 次读取等于 700 KB,1 次 ctx_execute 等于 3.6 KB。
这条主张对模型角色的定位很直接:把模型当代码生成器,别当数据处理器。
值得说清的是它自己划了边界:README 明确写了不做"文风约束"。它管的是数据往哪去,不管模型怎么说话。原文还引了一条理由:激进的简洁提示词会拉低编码与推理基准。
这条自律很少见。多数上下文优化工具会顺手限制输出长度,它明确不做。
三、沙箱是真子进程
ctx_execute 每次调用起一个隔离子进程,有自己的进程边界,脚本之间不能访问彼此的内存与状态。子进程跑代码,抓 stdout,只有 stdout 进对话上下文。
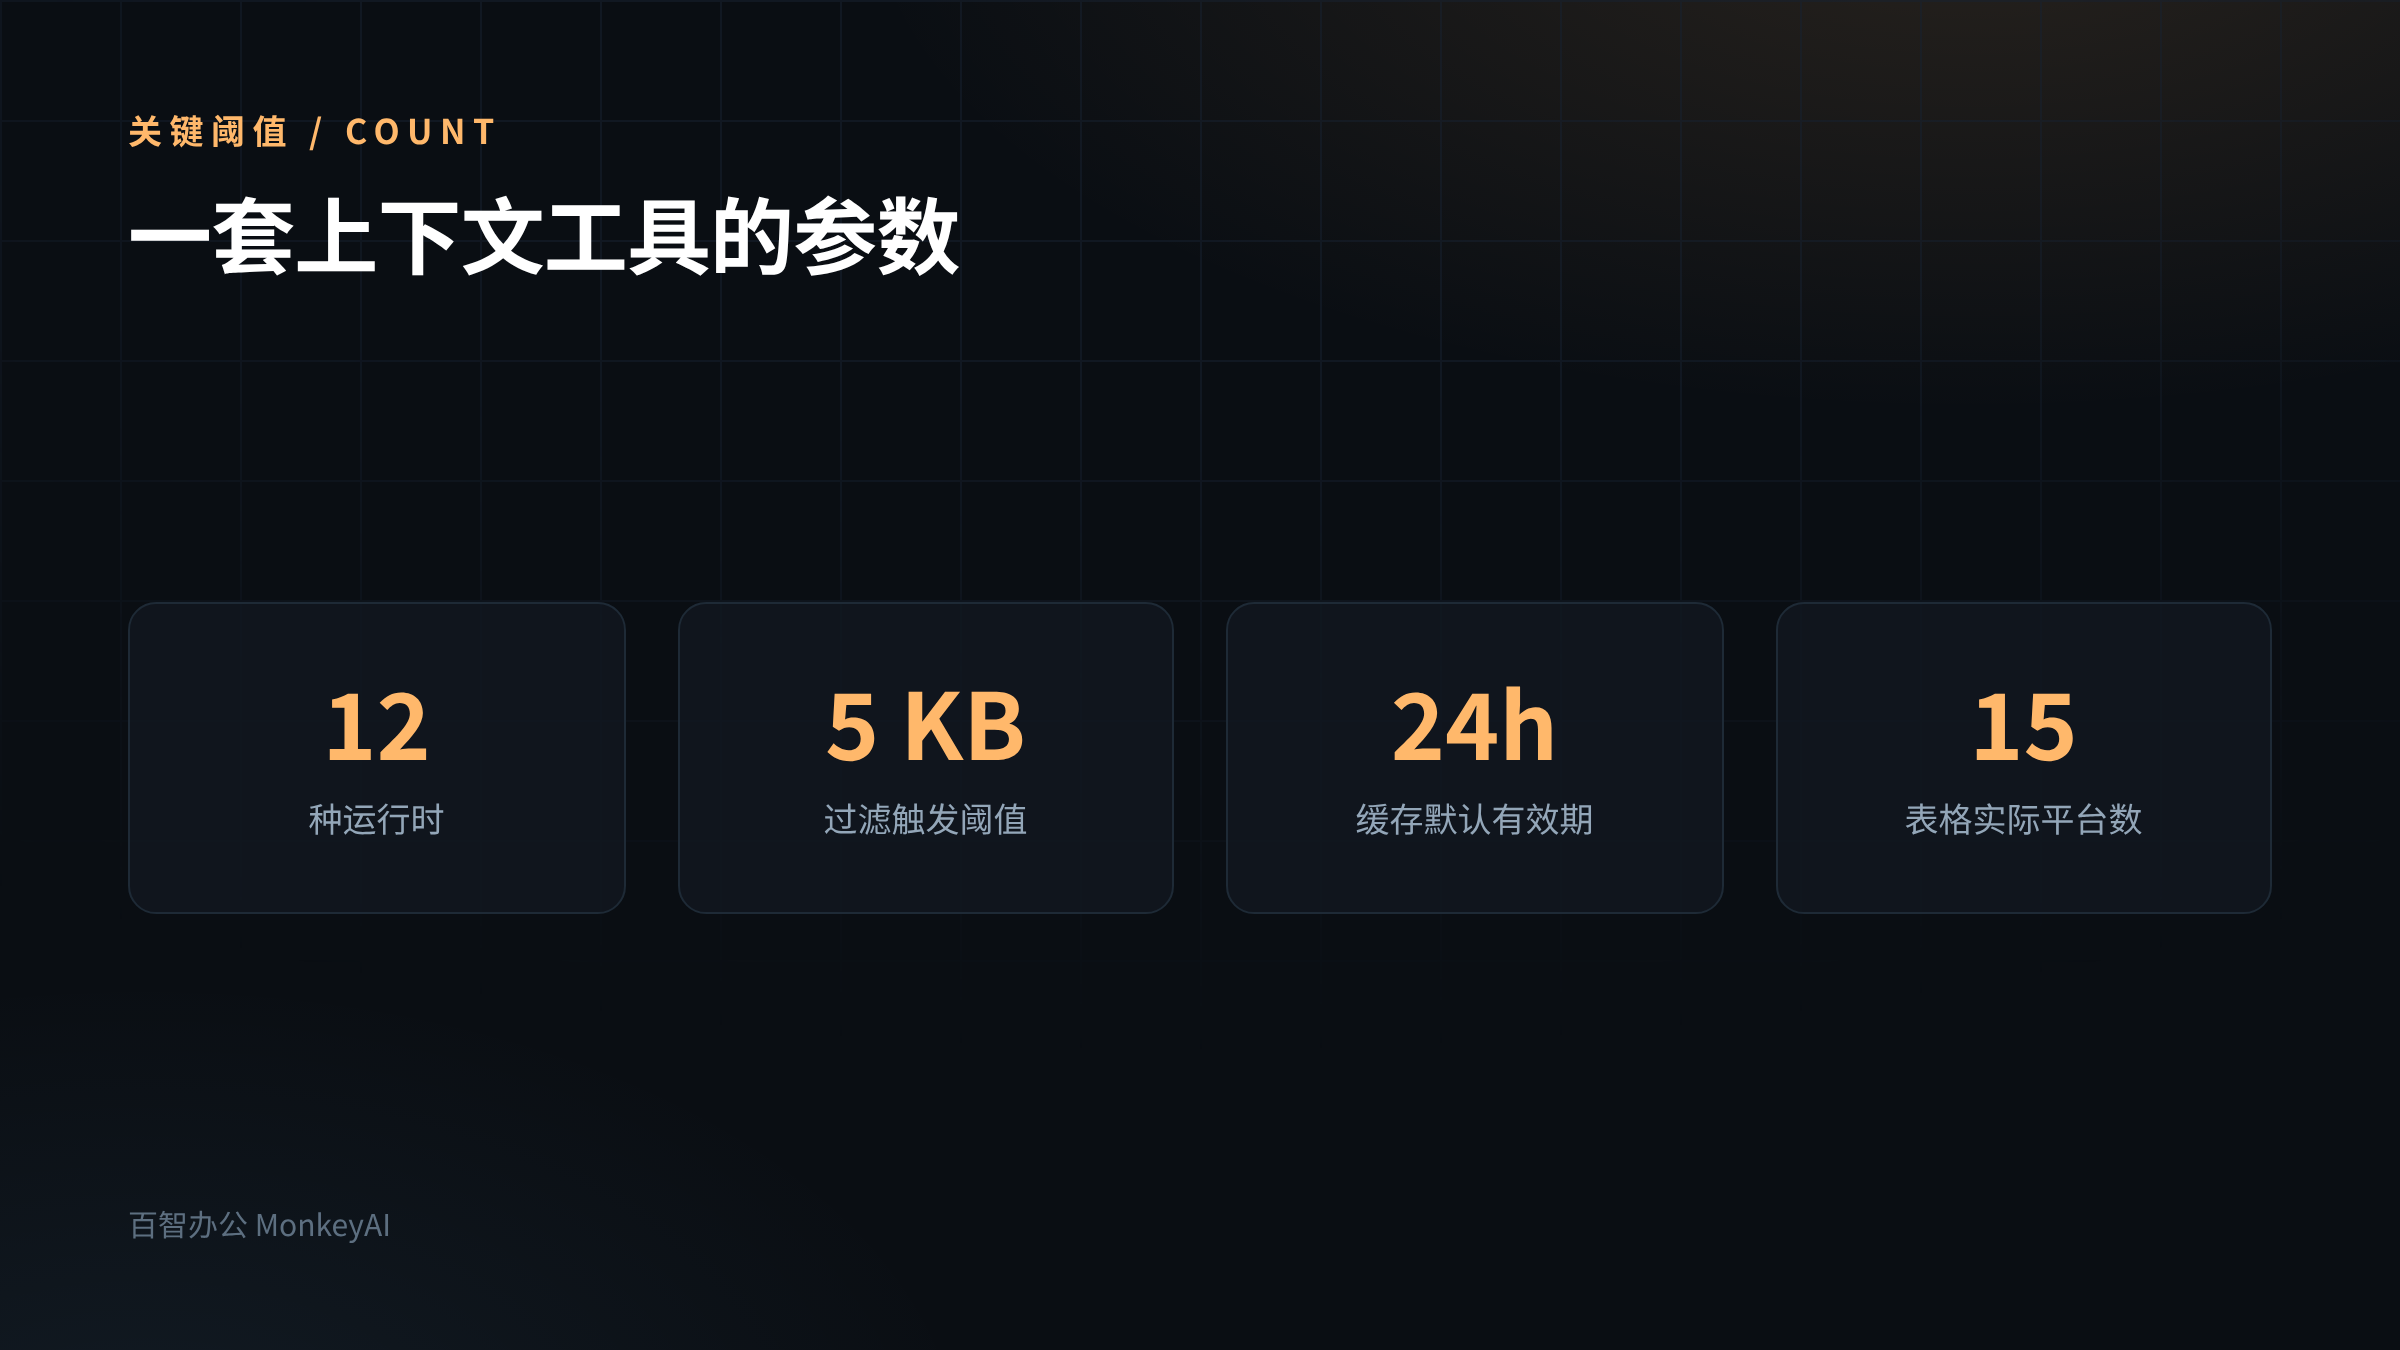
十二种运行时可用:JavaScript、TypeScript、Python、Shell、Ruby、Go、Rust、PHP、Perl、R、Elixir、C#。Bun 会被自动识别,JS 与 TS 快 3 到 5 倍。
认证类 CLI 走"凭据透传":gh、aws、gcloud、kubectl、docker 继承环境变量与配置路径,但不把它们暴露到对话里。
这条设计是关键。没有它,Agent 想查云资源就得把密钥贴进对话。有了它,命令能跑,密钥不进上下文。
【四、输出超过 5 KB 才启用意图过滤】
这条阈值值得记:输出超过 5 KB 且提供了 intent 参数时,它切到意图驱动过滤——把完整输出索引进知识库,按意图检索相关段落,只返回匹配部分,并给出一组可继续搜索的词汇。
5 KB 以下直接返回,不做过滤。这个分寸合理:小输出过滤的收益不如开销。
五、知识库的检索做了四层
ctx_index 按标题切块,保持代码块完整,存进 SQLite 的 FTS5 虚拟表。
检索的部分做得比多数同类工具细:
机制:BM25 排序;作用:按词频、逆文档频率、文档长度归一化打分
机制:Porter 词干;作用:running、runs、ran 归到同一词干
机制:Trigram 子串;作用:useEff 能命中 useEffect
机制:RRF 融合;作用:两路结果合并排序
机制:邻近重排;作用:多个查询词靠得近的结果加权
机制:模糊纠正;作用:用编辑距离纠错,kuberntes → kubernetes
机制:智能片段;作用:围绕命中词取窗口,不用截断
机制:TTL 缓存;作用:默认 24 小时,过期静默重抓
标题与标题的权重在 BM25 里乘 5。这个系数对导航类查询很有用:搜"配置",标题里有"配置"的文档应该排在正文提了一句的前面。
RRF 那段它写了一句设计演进:以前是级联回退,trigram 只在 porter 没结果时才用;现在两路并行再融合,两路都排得高的文档会浮上来。
这条改动体现的经验值得记:级联回退会丢掉两路都命中的信号。
六、限流是渐进式的
调用次数也做了限制:
次数:1 到 3;行为:正常,每次 2 条结果
次数:4 到 8;行为:减少到 1 条,给警告
次数:9 次以上;行为:阻断,重定向到批量执行
这条防止模型陷入"反复搜同一个词"的循环。多数工具不限次,结果是上下文被检索结果填满,比不检索更糟。
七、平台表里的数字对不上
README 说这套做法"在全部 17 个受支持客户端上都是强制范式"。
但平台对照表我只数出 15 行:Claude Code、Gemini CLI、VS Code Copilot、JetBrains Copilot、GitHub Copilot CLI、Cursor、OpenCode、OpenClaw、Codex CLI、Antigravity、Antigravity CLI、Kiro、Zed、Pi、OMP。
差两个。可能是表格没更新,也可能是把某个平台的多个变体算作多条。我没法从文档里确定。
比数字更值得看的是表里那两列:有钩子和没钩子的对比。
状态:有钩子;节省比例:约 98%
状态:没钩子;节省比例:约 60%
差 38 个百分点。README 的解释是:钩子能程序化拦截工具调用,在数据进入上下文之前就重定向;指令文件只能靠提示词引导模型,拦不住。
它还写了一句很实在的话:只要有一个没被路由的 curl 或 Playwright 快照,一次 56 KB,就能把一整场会话的节省全抹掉。
这条对做落地方案的人最重要。上下文优化要看最坏情况会不会翻车,平均节省量只是参考。
Antigravity 与 Zed 两个平台是 --,即不支持的钩子,得手工复制一次路由文件。
八、不续接就清空
README 里有一条容易被忽略的默认行为:不带 --continue 时,上一次的会话数据立即删除。
这条决定了它的数据留存策略:默认不留跨会话历史。
对个人使用方便,对企业要评估:如果希望长期保留工作轨迹,得靠续接参数或显式导出。
九、和百智办公的关系
环节:大输出处理;context-mode:子进程沙箱,只回 stdout;百智办公:由技能约定输出格式
环节:检索;context-mode:SQLite FTS5 + 混合排序;百智办公:资源管理 → 知识库
环节:知识文档;context-mode:ctx_index 切块索引;百智办公:知识库上传与解析
环节:跨会话;context-mode:默认删除,续接才留;百智办公:项目与会话组织
第 1 行是能抄的做法。百智办公没有内置的脚本沙箱,但可以在技能里约定:处理大文件时先汇总,只回报统计结果,不贴原文。
第 2 行对应关系近。知识库的检索质量取决于文档结构:标题清楚、摘要准确、代码块完整。
十、在百智办公里怎么落
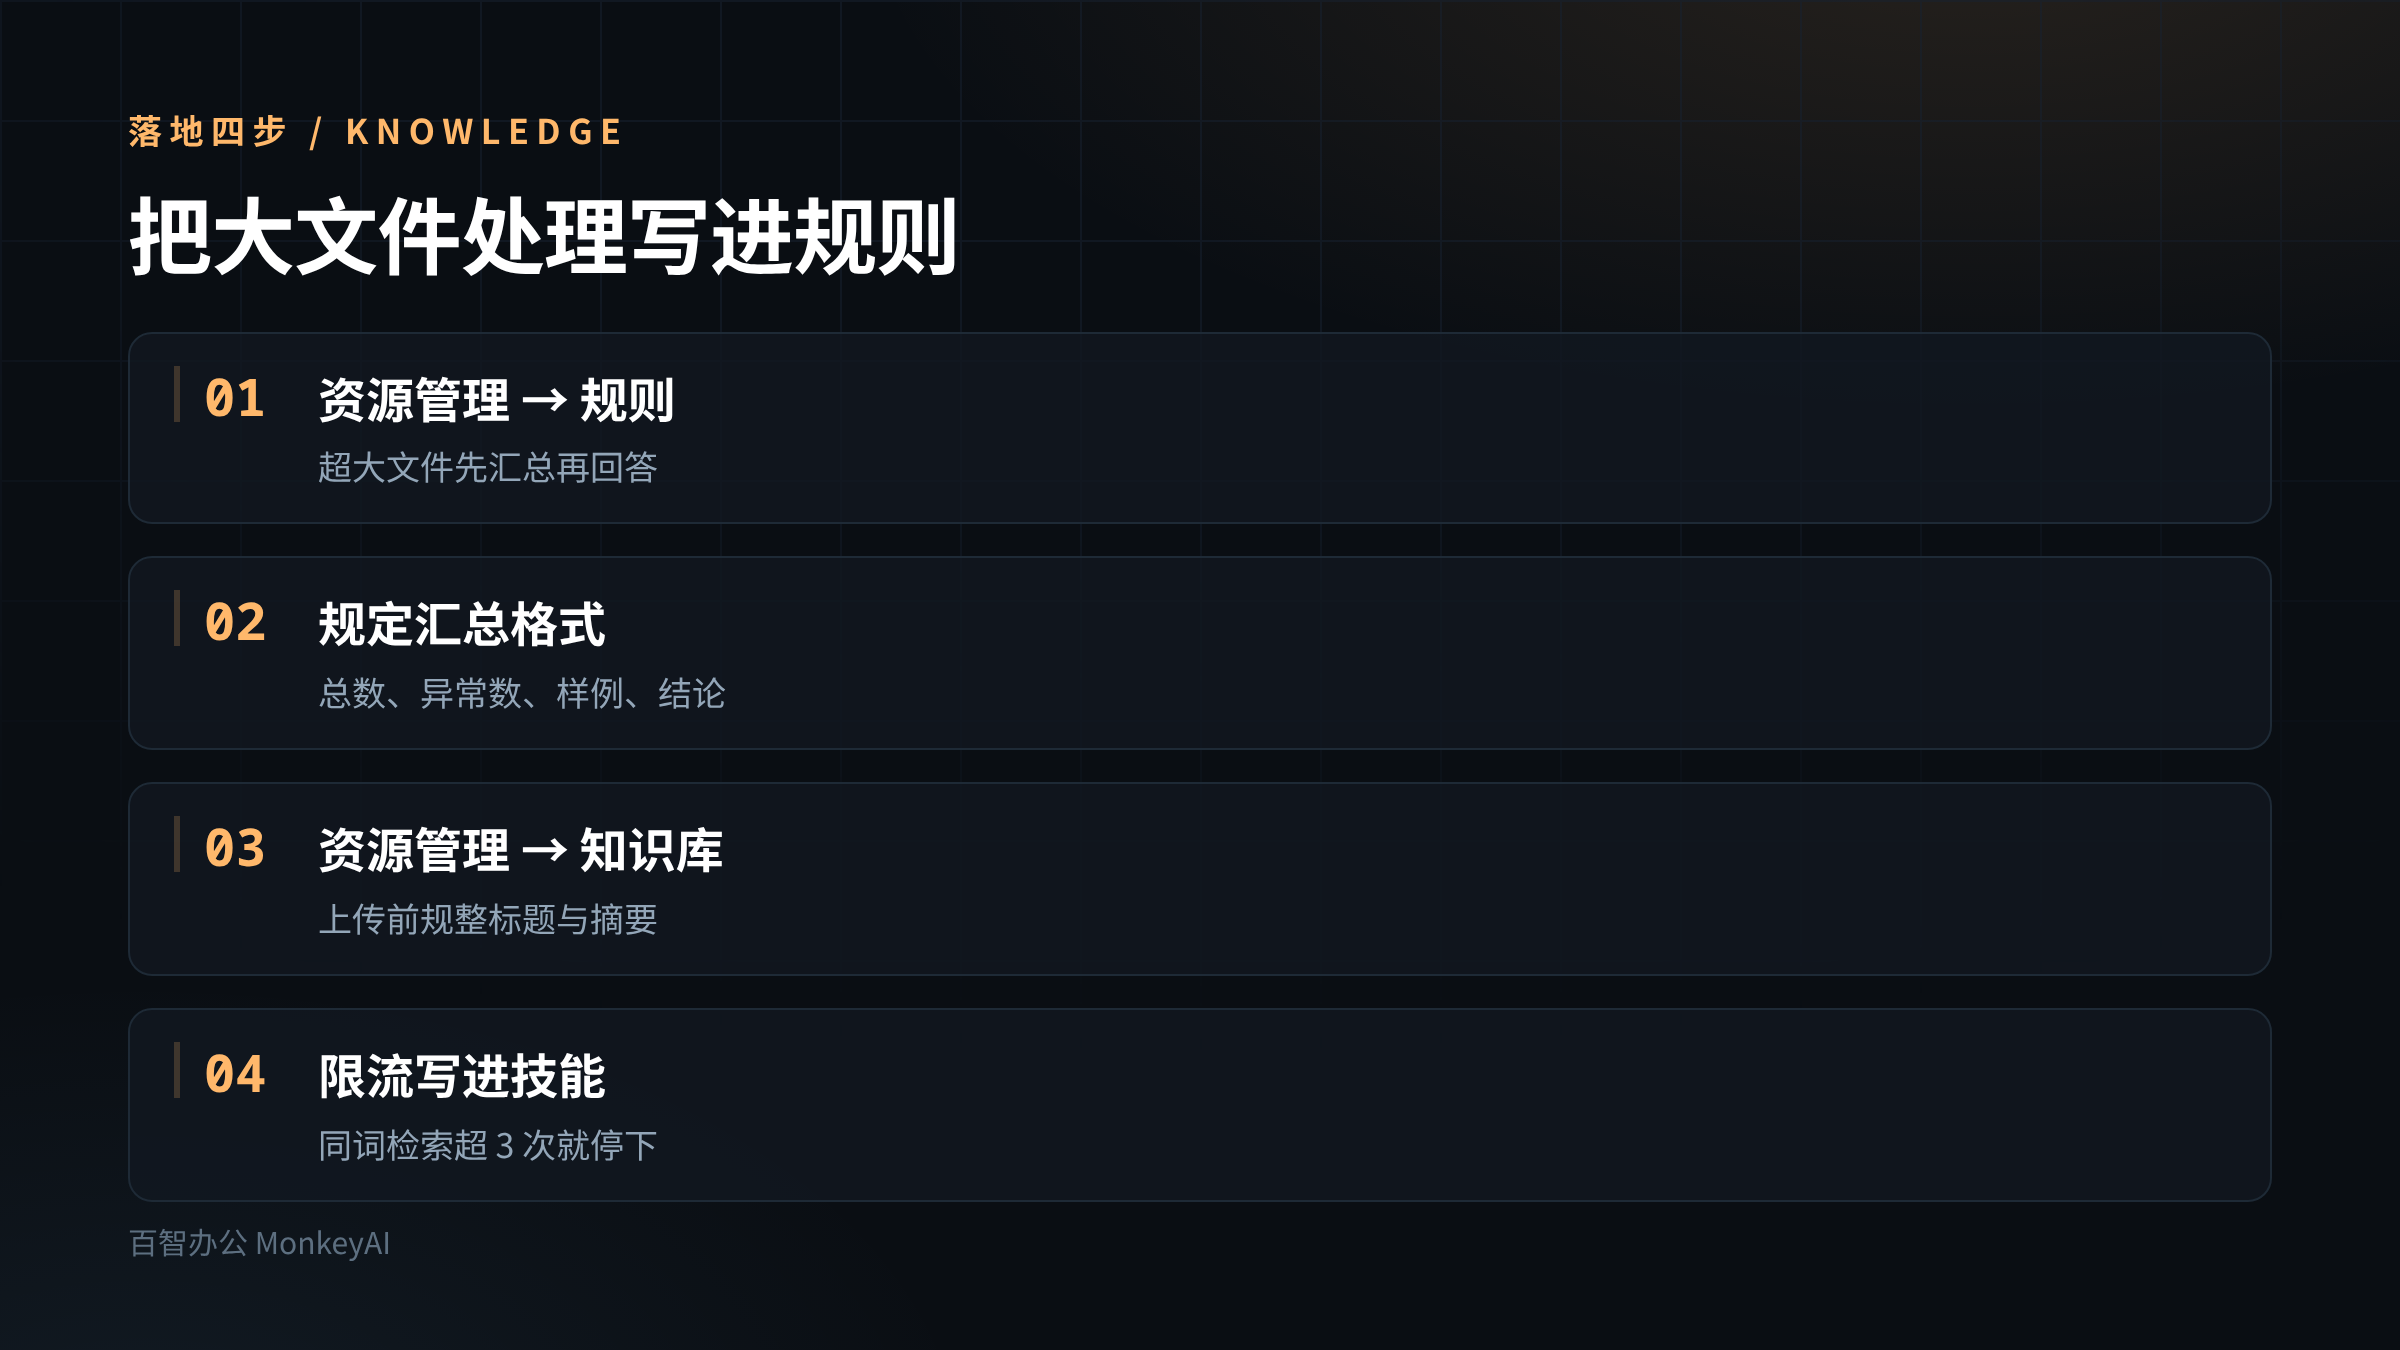
- 「资源管理 → 规则」加一条处理大文件的约定:超过某个行数或字节数时,先汇总再回答,不贴原文。
- 同一条规则里给出汇总格式:总条数、异常条数、前几条样例、结论。
- 「资源管理 → 知识库」上传文档前先规整结构:标题层级清楚、代码块独立、每篇有摘要。
- 「资源管理 → 技能」建一个"资料检索"技能,要求先给命中清单与相关性判断,再展开。
- 技能里写限流规则:同一关键词检索超过 3 次,改为换词或让我补充信息。
- 涉及密钥的操作,在技能里规定只调用已配置的连接器,不把密钥写进提示词。
- 每季度看一次任务记录,找出上下文消耗最高的几类任务,针对性写规则。
第 5 条对应它的渐进限流。反复搜同一个词是模型最常见的行为退化。
第 6 条对应它的凭据透传思路:能用配置解决的,不要走对话。
十一、可以直接抄的提示词
你在处理一批数据。先判断规模,再决定怎么读。
第 1 步:估规模
· 文件多少个、总共多少行
· 超过 20 个文件或 5000 行,进入汇总模式
第 2 步:汇总模式
· 不要逐个读完再复述
· 先给出结构:有哪些目录、每类文件多少个
· 抽样看 3 到 5 个代表性文件
· 只有结论需要明细时才取明细
第 3 步:输出
· 总条数与分类计数
· 异常项:数量 + 前 3 条样例 + 判断依据
· 结论与建议下一步
硬性要求:
- 不要把原始文件内容整段贴进回答。
- 需要看细节时,说明为什么这几处需要,只取这几处。
- 同一关键词检索超过 3 次没结果,停下来问我。
- 涉及密钥时只说用了哪个连接器,不要输出密钥内容。
第 1 条的估算门槛可以按团队习惯改。重点是让模型先估算,再决定策略。
十二、四个坑
坑一:以为装了就有 98%。
有钩子约 98%,没钩子约 60%。一个没被路由的大输出就能抹掉整场节省。
坑二:把降幅当成窗口占用率。
98% 是"原始数据与进入上下文的量"之比,衡量的是传输量。
坑三:小输出也走过滤。
它的阈值是 5 KB,以下直接返回。盲目过滤会引入额外调用成本。
坑四:指望它默认跨会话记忆。
不带续接参数时会话数据会删除。要留存得自己设计。
十三、边界
· 32,629 星、ELv2 许可、三个典型数据量、315 KB 到 5.4 KB、十二种运行时、5 KB 阈值、四层检索机制、渐进限流、98% 与 60% 两档、默认删除行为:GitHub 仓库页面与 README.md,2026-10-28 抓取。星数会变。
· README 写"17 个受支持客户端",平台对照表实际列出 15 行(Claude Code、Gemini CLI、VS Code Copilot、JetBrains Copilot、GitHub Copilot CLI、Cursor、OpenCode、OpenClaw、Codex CLI、Antigravity、Antigravity CLI、Kiro、Zed、Pi、OMP):README 原文与表格逐行对照,2026-10-28。差两个的原因文档里没写。
· 我没有安装它,没有跑过 ctx_execute,也没有复现 98% 的降幅。数字来自 README 的自述口径。
十四、事实来源
· 星数、许可、三个典型数据量、降幅、四条主张、沙箱机制、十二种运行时、凭据透传、5 KB 阈值、检索机制细节、渐进限流、平台表与两档节省、默认删除:GitHub 仓库 mksglu/context-mode 页面与 README.md,2026-10-28
· 平台行数统计:README 平台对照表逐行计数,2026-10-28
· 规则配置、知识库、技能、连接器、任务记录:官方文档《规则配置》《知识库》《技能导入与使用》《连接器》《任务记录》,2026-10-28 核对