HKUDS/DeepTutor 在 GitHub 上 46,521 星,Apache-2.0。定位是"智能体原生的学习工作台"。
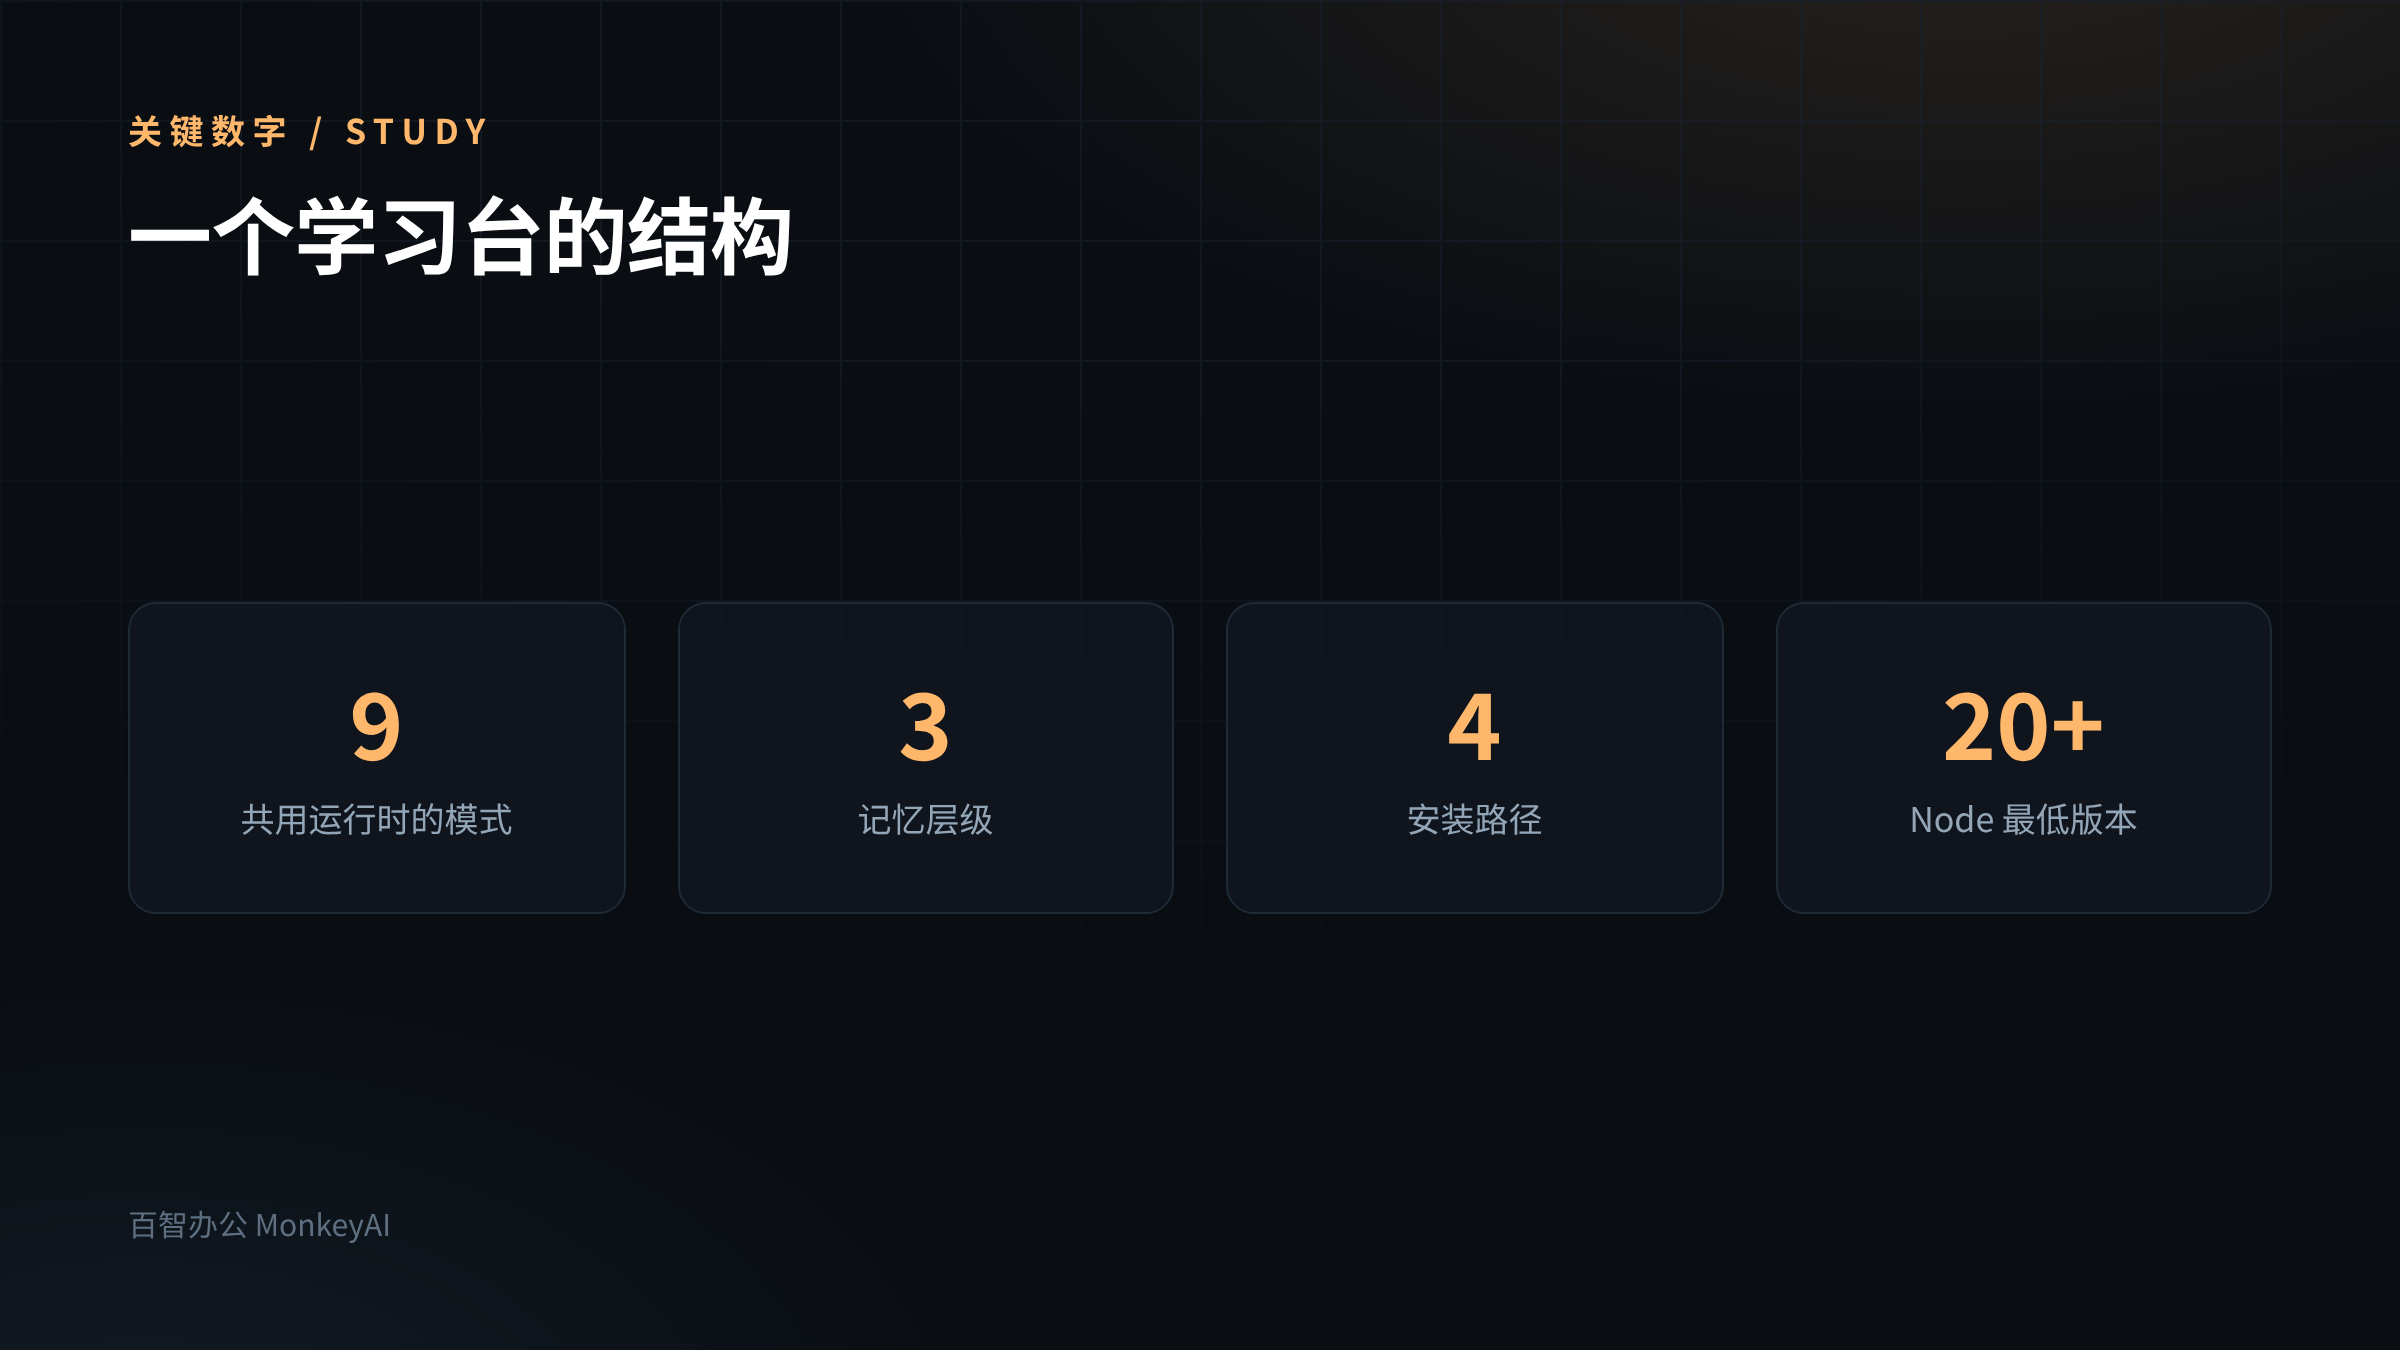
它把一个学习工具做成了九种模式共用一套运行时:对话、提问、测验、调研、可视化、解题、精修路径、沉浸阅读、音频概览。
这九种模式共享会话上下文。学完一章接着出题,题目接着进题库,题库接着进复习路径,中间不用把资料再贴一遍。
【一、学习工具最常见的问题是上下文断开】
用过学习类产品的人都有这个体验:读完一章,想让它出题,得重新说明背景;出完题想让它总结薄弱点,又得再说一遍。
DeepTutor 把这件事定义成架构问题。它的做法是让九种模式跑在同一个能力运行时和会话上下文上,各自保留自己的循环与流水线。
这句话值得抄进任何做智能体产品的设计文档:共用上下文,各留专用流程。
共用是为了不重复交代,专用是为了每种任务有合适的推法。两者都做,才不至于做成一个大而全的聊天框。
【二、任务板:学习也需要待办】
文档里有一块叫任务板,分待办、进行中、完成三列,卡片可以写备注,可以拖拽,也可以用键盘按钮移动,归档后能恢复。
它特意写了一句:卡片留在当前工作区,不需要配置模型。
最后半句是个设计信号。做学习工具的人容易把"AI 生成任务"当卖点,它把任务板做成了一个纯本地的手写清单。
AI 在学习场景里最容易喧宾夺主。任务板不做智能,反而更好用,因为学习计划是人自己最清楚的部分。
【三、视频学习:时间戳对齐是硬要求】
沉浸阅读里可以加 YouTube 或 Bilibili 链接,做原生播放、字幕搜索、基于时间戳的问答、记笔记、断点续学。
字幕搜索与时间戳对齐这两条是硬门槛。多数"用视频学习"的工具做不到"你问一句,它答完告诉你去第几分钟看"。
Bilibili 支持这一点对中文用户价值高。国内做学习工具的产品,多数只支持本地文件或自建视频库。
它还留了一个可配置项:YouTube 字幕与浏览可以走管理员配置的 Invidious 实例。这条是企业内网部署时的实际需求。
四、知识库要按形态分接
它列的知识源清单很长:LlamaIndex、PageIndex、GraphRAG、LightRAG 本地、远程 LightRAG 服务、自托管 WeKnora、腾讯 IMA、MarginNote 4、Kiwix ZIM 离线包、Obsidian 库,文档解析可插拔。
这张清单传达的信息是:知识库的形态远不止向量检索一种。
引擎:LlamaIndex;适合的检索形态:通用切块加向量
引擎:PageIndex;适合的检索形态:按页面与版面定位
引擎:GraphRAG;适合的检索形态:实体关系与多跳
引擎:LightRAG;适合的检索形态:轻量图谱,成本更低
引擎:Kiwix ZIM;适合的检索形态:离线百科,无网环境
不同引擎回答不同问题。"这份合同第几条说了什么"和"这几份报告之间有哪些矛盾",靠的是两套检索。
文档里还有一条关于 LightRAG 的细节:抽取、查询、视觉三类模型可以各自独立配置,创建时只写默认值,重建需要确认。
这条对应一个常见事故:改了嵌入模型没重建索引,检索结果全乱。要求"重建需确认"就是在防这个。
【五、记忆分三层,可查看可改】
这一块是它最有特色的部分。
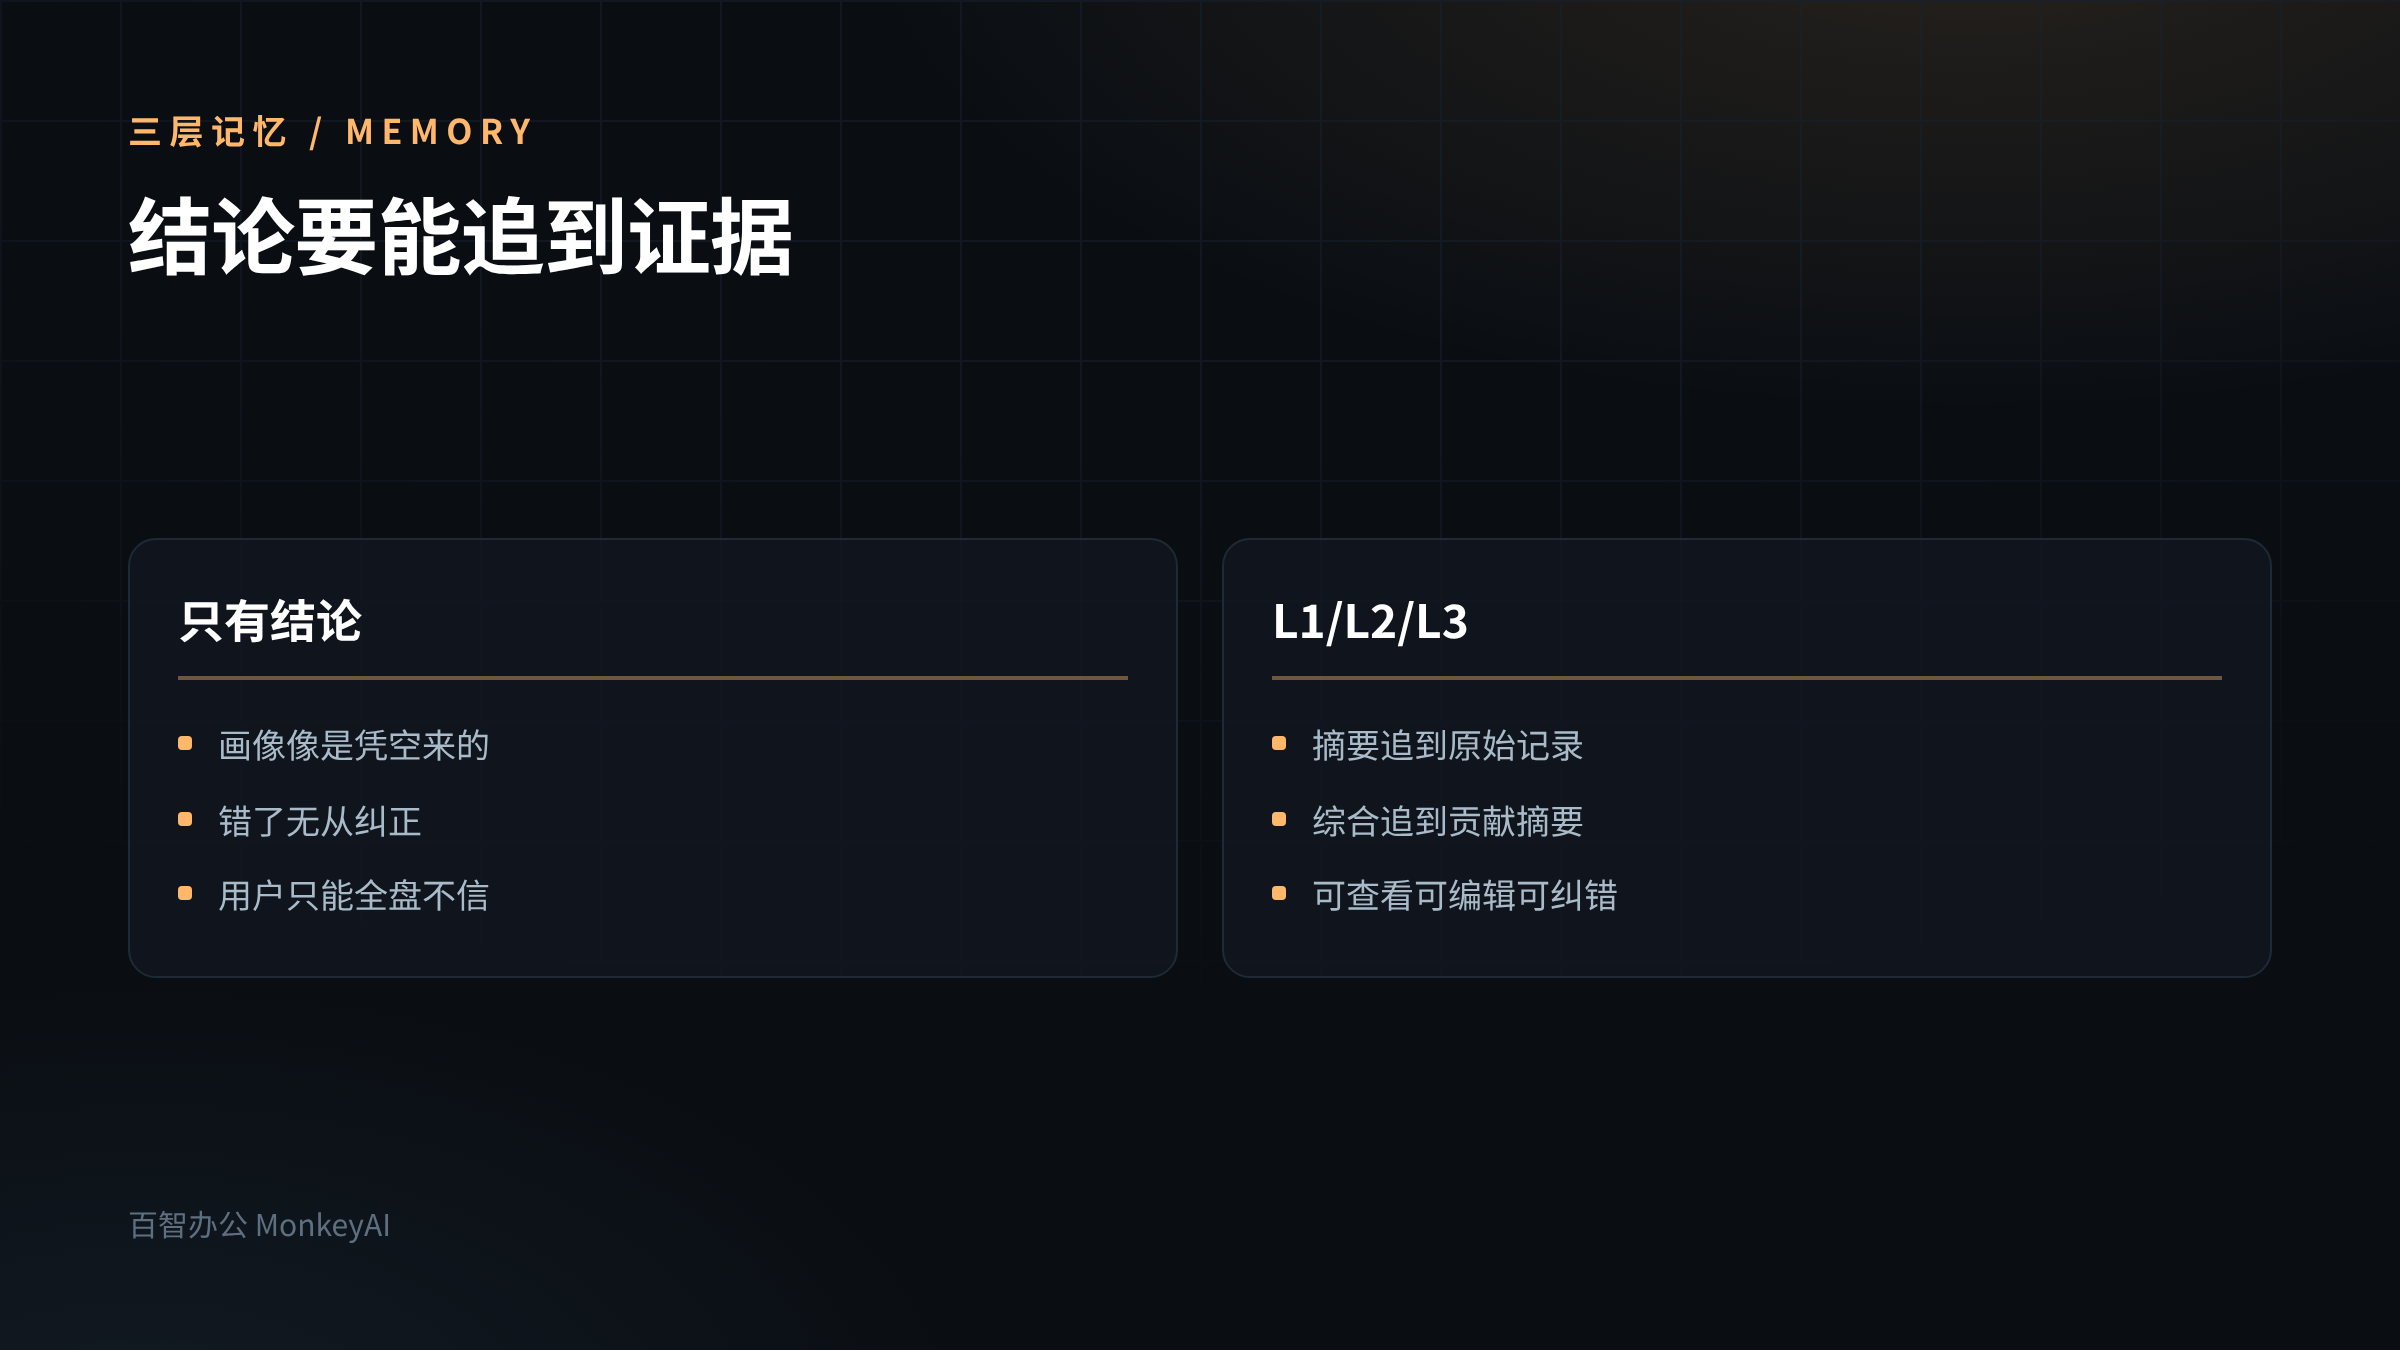
文档写:L1 轨迹、L2 表层摘要、L3 综合结论,让个性化可见可编辑;记忆图谱把 L2 事实连到 L1 证据,把 L3 综合结论连到贡献它的表层。
拆开看是三个层次:
层:L1 轨迹;内容:原始交互记录;作用:证据
层:L2 摘要;内容:从轨迹抽出的事实;作用:可复用结论
层:L3 综合;内容:多个事实合成的判断;作用:个性化画像
三层的关系是有向的:摘要能追到原始证据,综合结论能追到贡献它的摘要。
这条设计解决的是记忆类产品最麻烦的问题:用户看到一个结论,不知道它从哪来,也没法反驳。
能追到证据,就能纠错。这是把记忆从黑箱变成可维护资产的关键一步。
六、把外部智能体当顾问
它有一个设计叫子智能体与伙伴:在对话里可以咨询一个在线智能体,清单里列了 Claude Code、Codex、Grok CLI、Antigravity、Kimi、opencode、MiMo、Hermes、OpenClaw、DeepSeek。
还能导入过去的对话,以及在同一个大脑上跑常驻的 IM 伙伴。
这个模式的实用点在于分工:学习台负责知识、进度、题库、记忆,编码智能体负责写代码、跑命令。
两条线各管一段,通过对话交接。比把所有能力塞进一个智能体更容易维护。
七、安装路径与前提
四条安装路径,共用一套运行时目录布局。推荐流程是:选运行时目录、安装、deeptutor init、deeptutor start。
pip install -U "deeptutor[full]"
mkdir -p my-deeptutor && cd my-deeptutor
deeptutor init
deeptutor start
版本 1.7.0 起改成分模块安装:deeptutor[full] 装 Web 应用加命令行,deeptutor 只装核心对话。功能模块版本必须与核心一致。
前提写得很具体:Python 3.11 到 3.14,Node.js 20 以上要在 PATH 里,因为打包的 Next.js 服务由 deeptutor start 拉起。
工作区可以用命令行管:
deeptutor workspace show
deeptutor workspace set /absolute/path/to/my-folder
deeptutor workspace reset
用一个目录管工作区,比在界面里上传文件更适合长期使用。资料留在本地,换机器时整目录拷走。
八、版本节奏透露的信息
README 的发布记录写得很密,从 2026 年 4 月的 beta 到 2026 年 10 月 28 日的 1.7.0,半年多时间几十个版本。
主线能看出优先级:先做架构重写与命令行,再做多引擎知识库与解析,再做任务板、视频学习、记忆分层,最近在修可靠性(恢复流、可恢复索引、明确的截断提示)。
中间有几个修复版本,标题直接写"某个失败是静默的"。能公开承认静默失败并专门修,说明团队在用真实数据跑。
这些是判断一个开源项目是否在生产使用的信号,比星数更可信。
九、在百智办公里怎么落
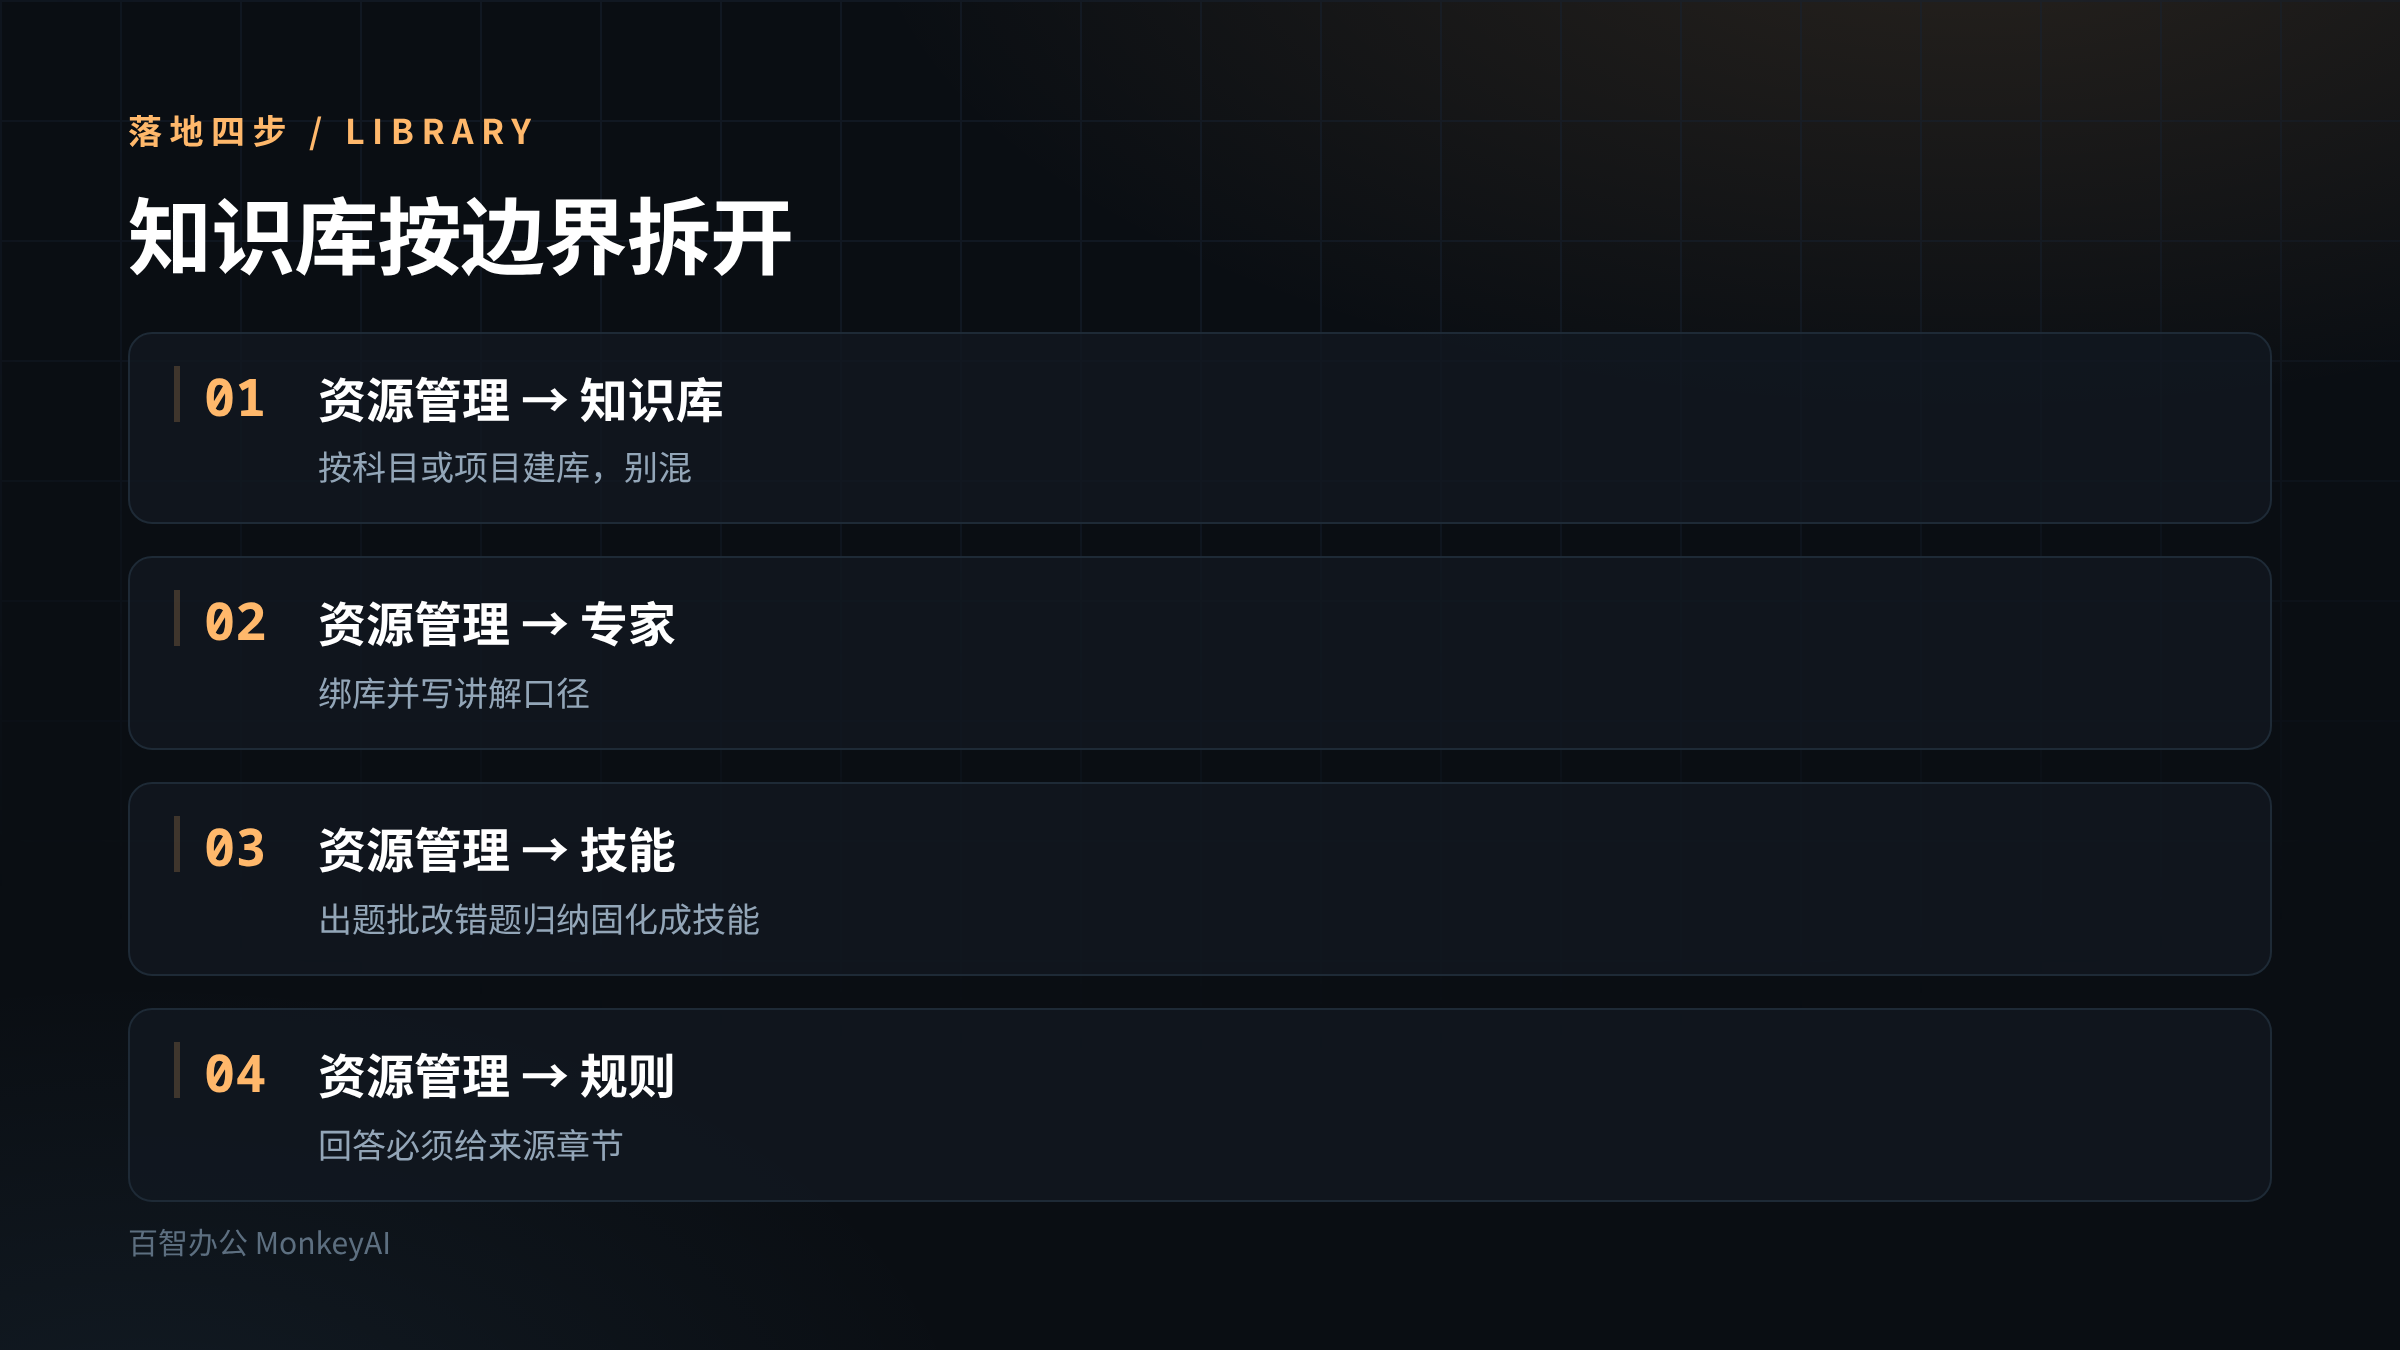
学习场景落到百智办公,主要是知识库加专家加技能的组法。
- 「资源管理 → 知识库」按科目或按项目建库,别把所有资料塞进一个库。检索质量取决于库的边界。
- 每个库只放这一类的资料:教材、真题、笔记分开。混库之后相似度排序会把不相干的段落排上来。
- 「资源管理 → 专家」建学科专家,绑定对应知识库,写清它的讲解口径与禁止事项。
- 「资源管理 → 技能」把重复动作做成技能:出题、批改、错题归纳、章节摘要。技能里固定输出格式,输出的表格才好统计。
- 「资源管理 → 规则」规定:回答必须给来源章节,找不到就说找不到,别编。
- 客户端「设置 → 助手配置」给不同人群分发不同专家:新人用入门专家,老手用进阶专家。
- 资料更新后重建索引,并在备注里记下重建日期。索引与资料不一致是最常见的检索出错原因。
第 5 条对应它的三层记忆里"能追到证据"这条。要求给来源,等于把摘要层强行绑回证据层。
第 7 条对应 LightRAG 那条"重建需确认"。资料变了不重建,比没有知识库更麻烦,因为检索会给出过时但看起来很权威的答案。
十、可以直接抄的提示词
帮我设计一套学科知识库的划分方案。
先列出我所有的资料类型与大致数量,然后给出:
- 库的划分:每个库的名字、边界(收什么、不收什么)、对应的人群
- 每库的切块策略:按章节、按页、按问答对,说明理由
- 更新流程:新资料进来怎么入库,什么时候必须重建索引
- 检索兜底:检索不到时专家该怎么回答,明确禁止编造
- 质检方法:准备哪几个问题能验证这个库检索是否正常
输出要求:
· 划分方案用表格:库名、收录范围、排除范围、使用人群
· 每个库给 3 个质检问题,问题要能区分"检索到了"和"蒙对了"
· 更新流程写成步骤,标明每步谁负责
· 兜底话术直接给成句,能贴进专家规则
硬性要求:
· 划分依据写清楚,别只给结果
· 有歧义的资料要单独说明放到哪个库、为什么
· 质检问题必须能用现有资料答出来,别出无解的题
第 5 条容易被忽略。知识库上线前没有质检题,出问题只能靠用户投诉发现。
十一、四个坑
坑一:九种模式共用一个库,边界糊掉。
模式共用上下文是好事,知识库混用则会出问题。库混了检索必然乱。
坑二:换嵌入模型不重建索引。
文档特意要求重建需确认,说明这是高频事故。
坑三:只做摘要不做证据链。
没有 L1 可追,摘要出错就无从纠正,用户只能全盘不信。
坑四:把学习计划交给 AI 生成。
它的任务板刻意不做智能。计划里最清楚的部分是人自己的目标与时间。
十二、边界
· 46,521 星、Apache-2.0、定位、九种模式共用运行时、任务板三列与无需模型配置、沉浸视频学习与时间戳问答与 Invidious 配置项、子智能体清单、知识源清单、LightRAG 三类模型独立配置与重建确认、L1/L2/L3 与记忆图谱、四条安装路径、Python 3.11-3.14 与 Node 20 以上、工作区三条命令、版本节奏与 1.7.0 内容:GitHub 仓库 HKUDS/DeepTutor 的 README.md,2026-10-28 抓取。星数会变。
· 我没有安装 DeepTutor,没有跑过任何模式,也没有验证视频时间戳对齐与记忆图谱的实际效果。所有能力描述来自 README 与发布记录。
十三、事实来源
· 星数、许可、九种模式、任务板、视频学习、子智能体与伙伴、多引擎知识库、三层记忆与记忆图谱、安装路径与命令、版本记录:GitHub 仓库 HKUDS/DeepTutor 的 README.md,2026-10-28
· 知识库、专家、技能、规则、助手配置与分发范围:官方文档《知识库管理》《专家》《技能导入与使用》《规则配置》《助手配置》,2026-10-28 核对