modelcontextprotocol/servers 在 GitHub 上有 91,607 星。仓库里只有 7 个参考服务器:everything、fetch、filesystem、git、memory、sequentialthinking、time。
README 开头就提醒:这些是参考实现,用来演示 MCP 特性与 SDK 用法,供开发者学习,不承担生产就绪的承诺。
真正稀缺的是另一件事。这个仓库用 11 个技能驱动自己的开发流程,并且为每个技能写了评测用例,还把测出来的触发率写进了文档。
技能发布之前,它先量了一遍管不管用。
一、仓库自己怎么分工
7 个参考服务器,按语言和用途分得很清楚:
服务器:everything;语言:TypeScript;干什么:把 MCP 全部特性演示一遍
服务器:filesystem;语言:TypeScript;干什么:文件操作,限定在允许目录与 Roots 内
服务器:memory;语言:TypeScript;干什么:知识图谱持久化
服务器:sequentialthinking;语言:TypeScript;干什么:分步推理
服务器:fetch;语言:Python;干什么:抓网页并转成适合模型的文本
服务器:git;语言:Python;干什么:Git 仓库操作
服务器:time;语言:Python;干什么:时间与时区换算
代码量不大:4.9MB,123 个 TypeScript 文件、25 个 Python 文件、44 份 Markdown。
工具数量按 registerTool 与工具定义统计:everything 26 个,filesystem 13 个,git 12 个,memory 9 个,time 2 个,fetch 与 sequentialthinking 各 1 个。
参考实现的价值在"最小可运行",所以工具少。fetch 只有 1 个工具,sequentialthinking 也只有 1 个。
【二、它给技能定了四条硬规则】
AGENTS.md 里有一节叫"维护技能",四条要求每条都能被脚本检查:
规则:verify:skills 必须通过;具体要求:按 Claude Code 的解析方式检查 frontmatter;不做的后果:描述解析为空,/名字 还能用,自动触发永远不发生
规则:显式声明 disable-model-invocation;具体要求:默认填 false;不做的后果:填 true 的技能无法被正文里的其他技能调用
规则:模型可调用的技能必须带评测用例;具体要求:至少 5 条正例、1 条负例;不做的后果:技能悄悄失效,没人发现
规则:列表预算不能超;具体要求:单条描述 1,536 字符,整份列表 4,000 字符;不做的后果:溢出时按调用次数从少到多丢弃
第 1 条最阴。YAML 写坏了不会报错,技能本体照样能手动打开,只是模型永远想不起来用它。这类故障静默、稳定、持续。
文档还补了一句更狠的:verify:skills 能证明技能格式正确,证明不了它"可被触达"。可达性得靠评测。
【三、评测怎么打分:只看首步】
docs/skill-authoring.md 把测量方法写得很细。评测跑在全新的无头会话里,每条用例重复多次,统计 Skill 工具以预期名字触发的比例。
两类用例,两套预算:
类型:expect 或 null;断言什么:技能是否模型的首次动作;回合预算:1 回合;结果列:首步命中
类型:chain;断言什么:加载 A 之后会不会接着加载目标技能;回合预算:14 回合;结果列:接力命中,阈值 0.5
首步规则是整套方法的地基:技能必须在模型的首个回合就触发。同一回合里先 Read 再 Skill 也算命中,因为扫描的是该回合所有工具调用块。
真正丢分的情形是:模型先读文件、看到结果,再决定——这个决定落在第二回合,而第二回合根本不会跑。
文档给了一张实测对照表,同一件事两种问法,首步完全不同:
提问:这个仓库的测试里,TUI 组件怎么挂载、按键怎么驱动?;首个被调用的工具:Bash
提问:这个仓库里我该怎么给一个 TUI 组件写测试?;首个被调用的工具:Skill
提问:这个仓库哪部分负责浏览器的 HTTP 传输?;首个被调用的工具:Bash
提问:只跑本地、不进 CI 的那部分检查是哪些?;首个被调用的工具:Read
提问:门禁在 lint 阶段失败了,我该怎么查?;首个被调用的工具:Skill
规律是"怎么做"配技能,"是什么""在哪里"配检索。
【四、描述怎么写:先动词,再场景】
文档给了一个模板:
description: 。Use when ;when ;
when ;or when 。
它附了三个测出来的数字:
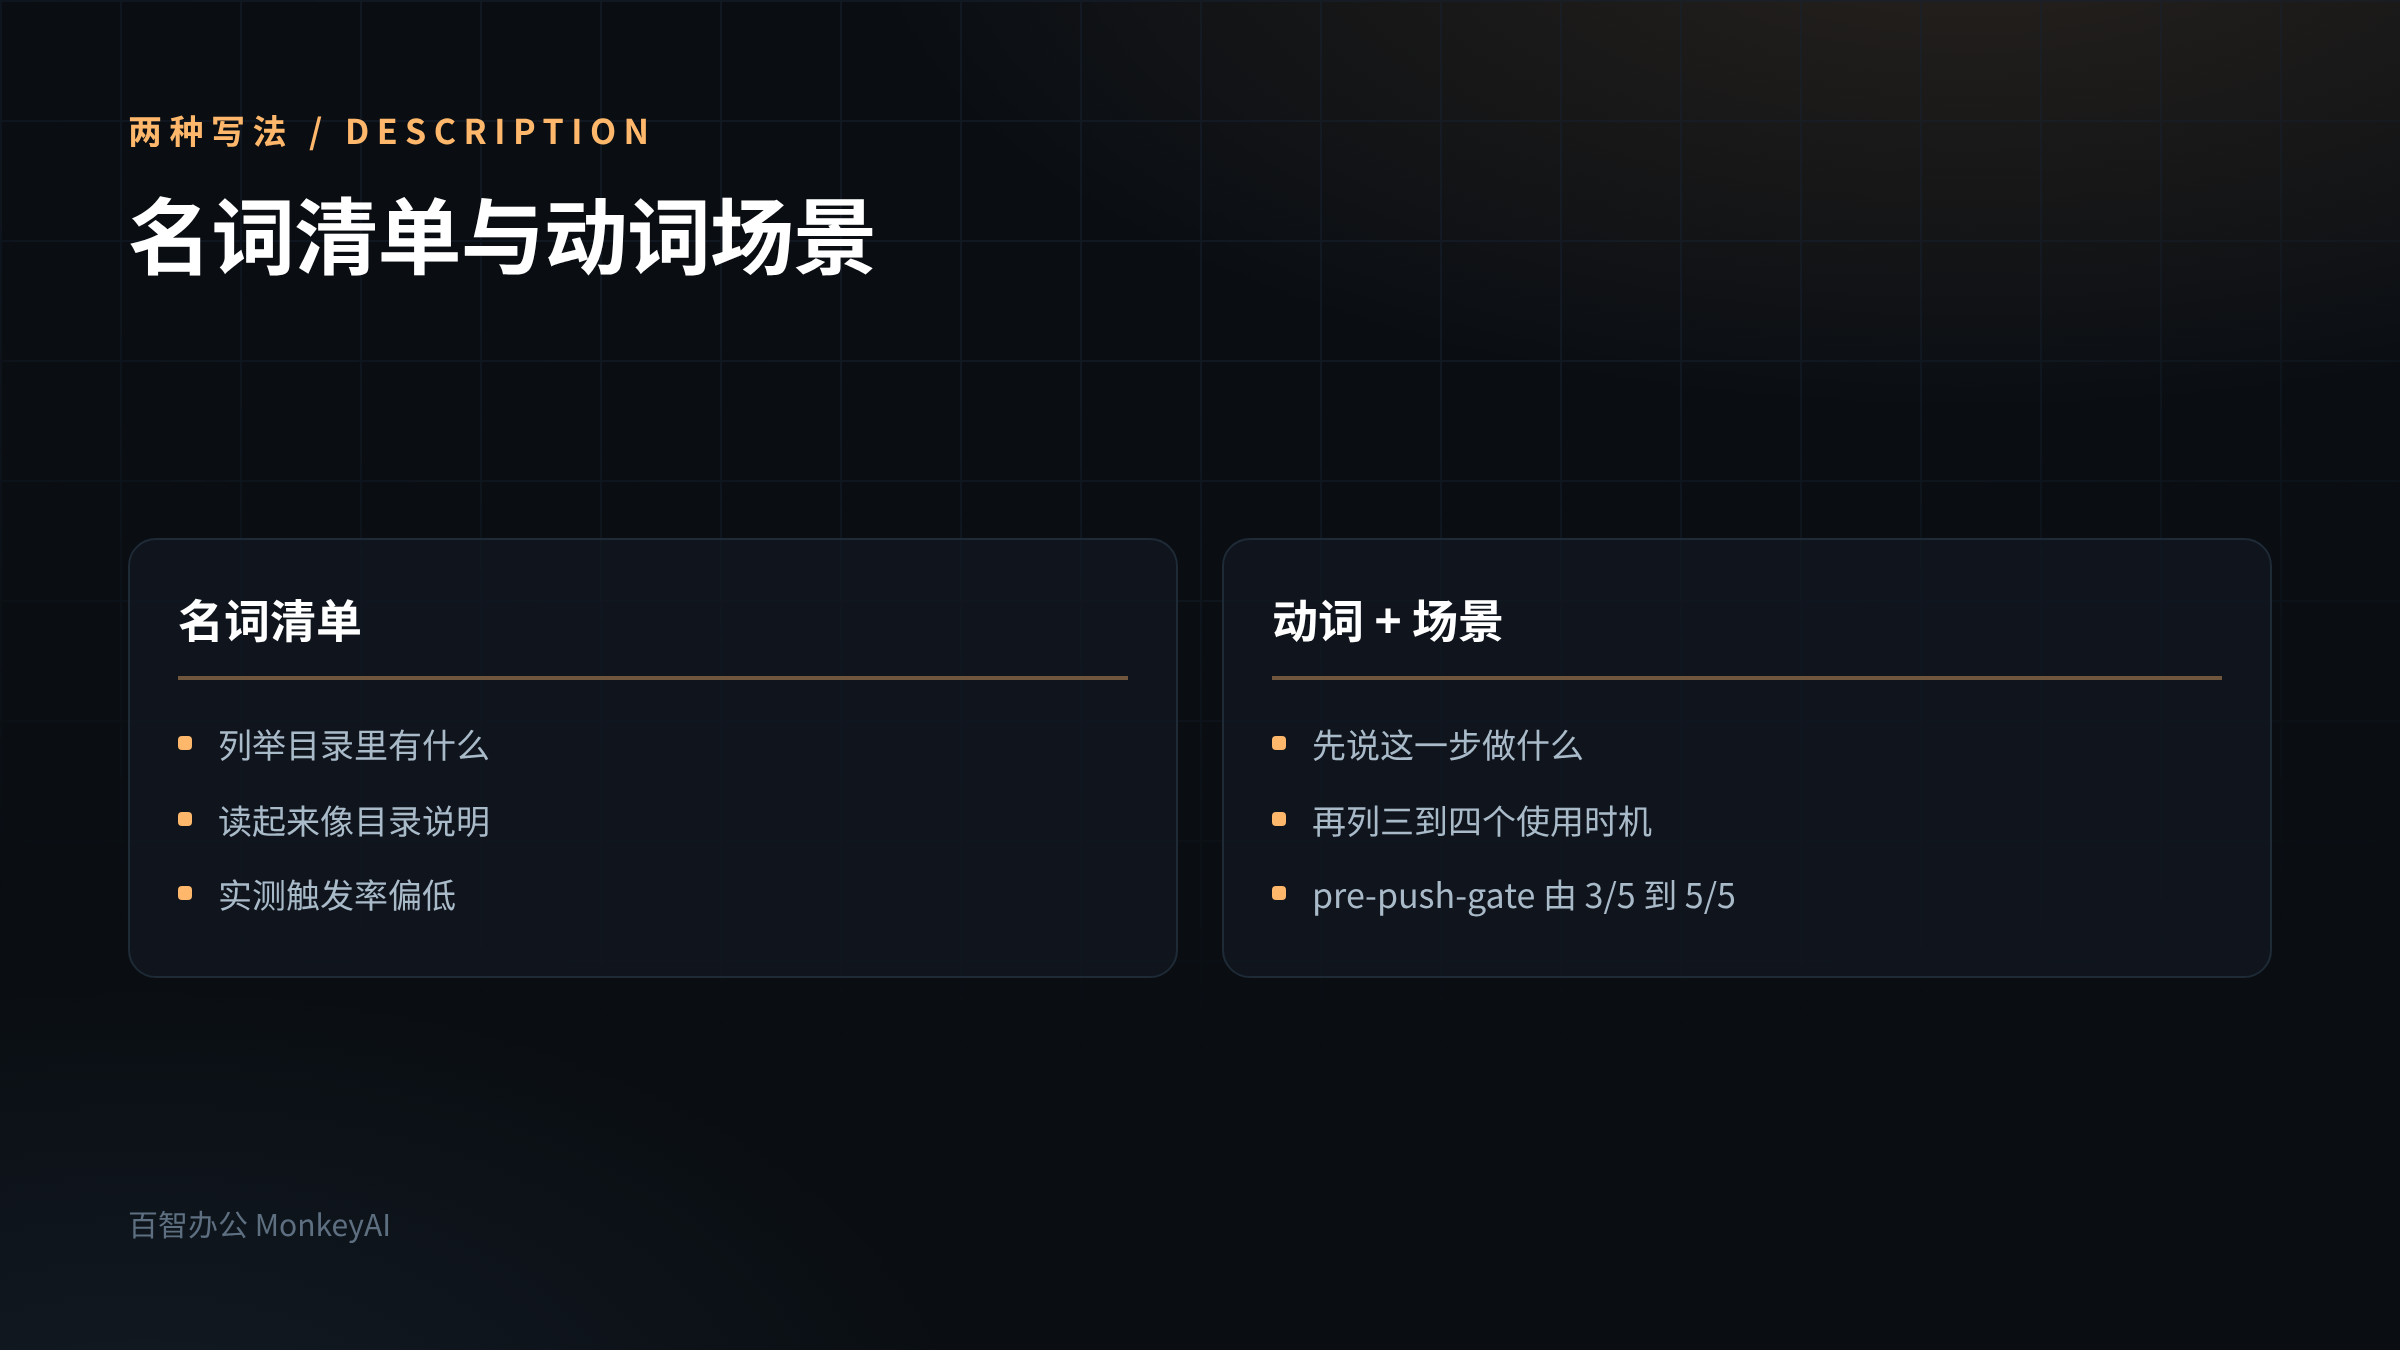
改动:把 pre-push-gate 的描述改成动词 + 场景式;变化:3/5 提升到 5/5
改动:testing 三条用例;变化:25% / 50% / 25% 提升到各自 100%
改动:给 testing 加 paths 字段;变化:对话触发率减半
第三条值得单独说。paths 看起来是免费的能力扩展,实测把对话触发率砍掉一半;而只用提示词的评测永远无法验证路径触发,加它等于交付一个无法测量的声明。
文档还写了两条反直觉的结论:
· 名词式的内容清单("这里放什么、core 里有什么、每个目录做什么")稳定劣于动词式描述。
· 从 3 个模型可调用技能增加到 9 个,已有技能的触发率可测地下降。上限在注意力,不在字符数。
所以规则是:新增技能或改描述后,必须重跑全套用例,不能只跑改动的那个。
五、它自己的技能长什么样
11 个技能,10 个带评测:
技能:board-ops;用例总数:9;正例:5;负例:4;接力用例:2
技能:pre-push-gate;用例总数:9;正例:7;负例:2;接力用例:0
技能:security-advisory;用例总数:9;正例:7;负例:2;接力用例:0
技能:client-smoke;用例总数:8;正例:6;负例:2;接力用例:0
技能:issue-triage;用例总数:8;正例:6;负例:2;接力用例:0
技能:local-dev;用例总数:8;正例:6;负例:2;接力用例:0
技能:pr-flow;用例总数:8;正例:6;负例:2;接力用例:0
技能:testing;用例总数:8;正例:6;负例:2;接力用例:0
技能:issue-create;用例总数:7;正例:5;负例:2;接力用例:0
技能:project-structure;用例总数:7;正例:5;负例:2;接力用例:0
技能:release;用例总数:无评测;正例:—;负例:—;接力用例:—
负例的计分方式特别:负例对这个仓库所有模型可调用技能一起算,只有全部都没触发才算通过。也就是说,负例测的是"这件事谁都不该接管"。
正例则只能声明自己的名字。verify:skills 会拒绝写别人名字的正例,理由是:一条在"另一个技能触发"时也能通过的用例,测的对象偏离了它声称的内容。
六、和百智办公的关系
百智办公的技能导入与这套方法可以直接对接,但评测那一层需要自己补:
环节:格式;标准与工具:SKILL.md + frontmatter;百智办公:同一套格式,支持 ZIP 或文件夹
环节:触发;标准与工具:靠 description;百智办公:同一机制,也可 /技能名 手动调用
环节:评测;标准与工具:仓库自建脚本;百智办公:需要团队自定用例
环节:分发;标准与工具:仓库内 .claude/skills;百智办公:团队 / 我的 / 他人分享三分类
第三行是缺口。格式与调用都一样,差别在"有没有人量过它到底会不会被用起来"。
七、在百智办公里怎么落
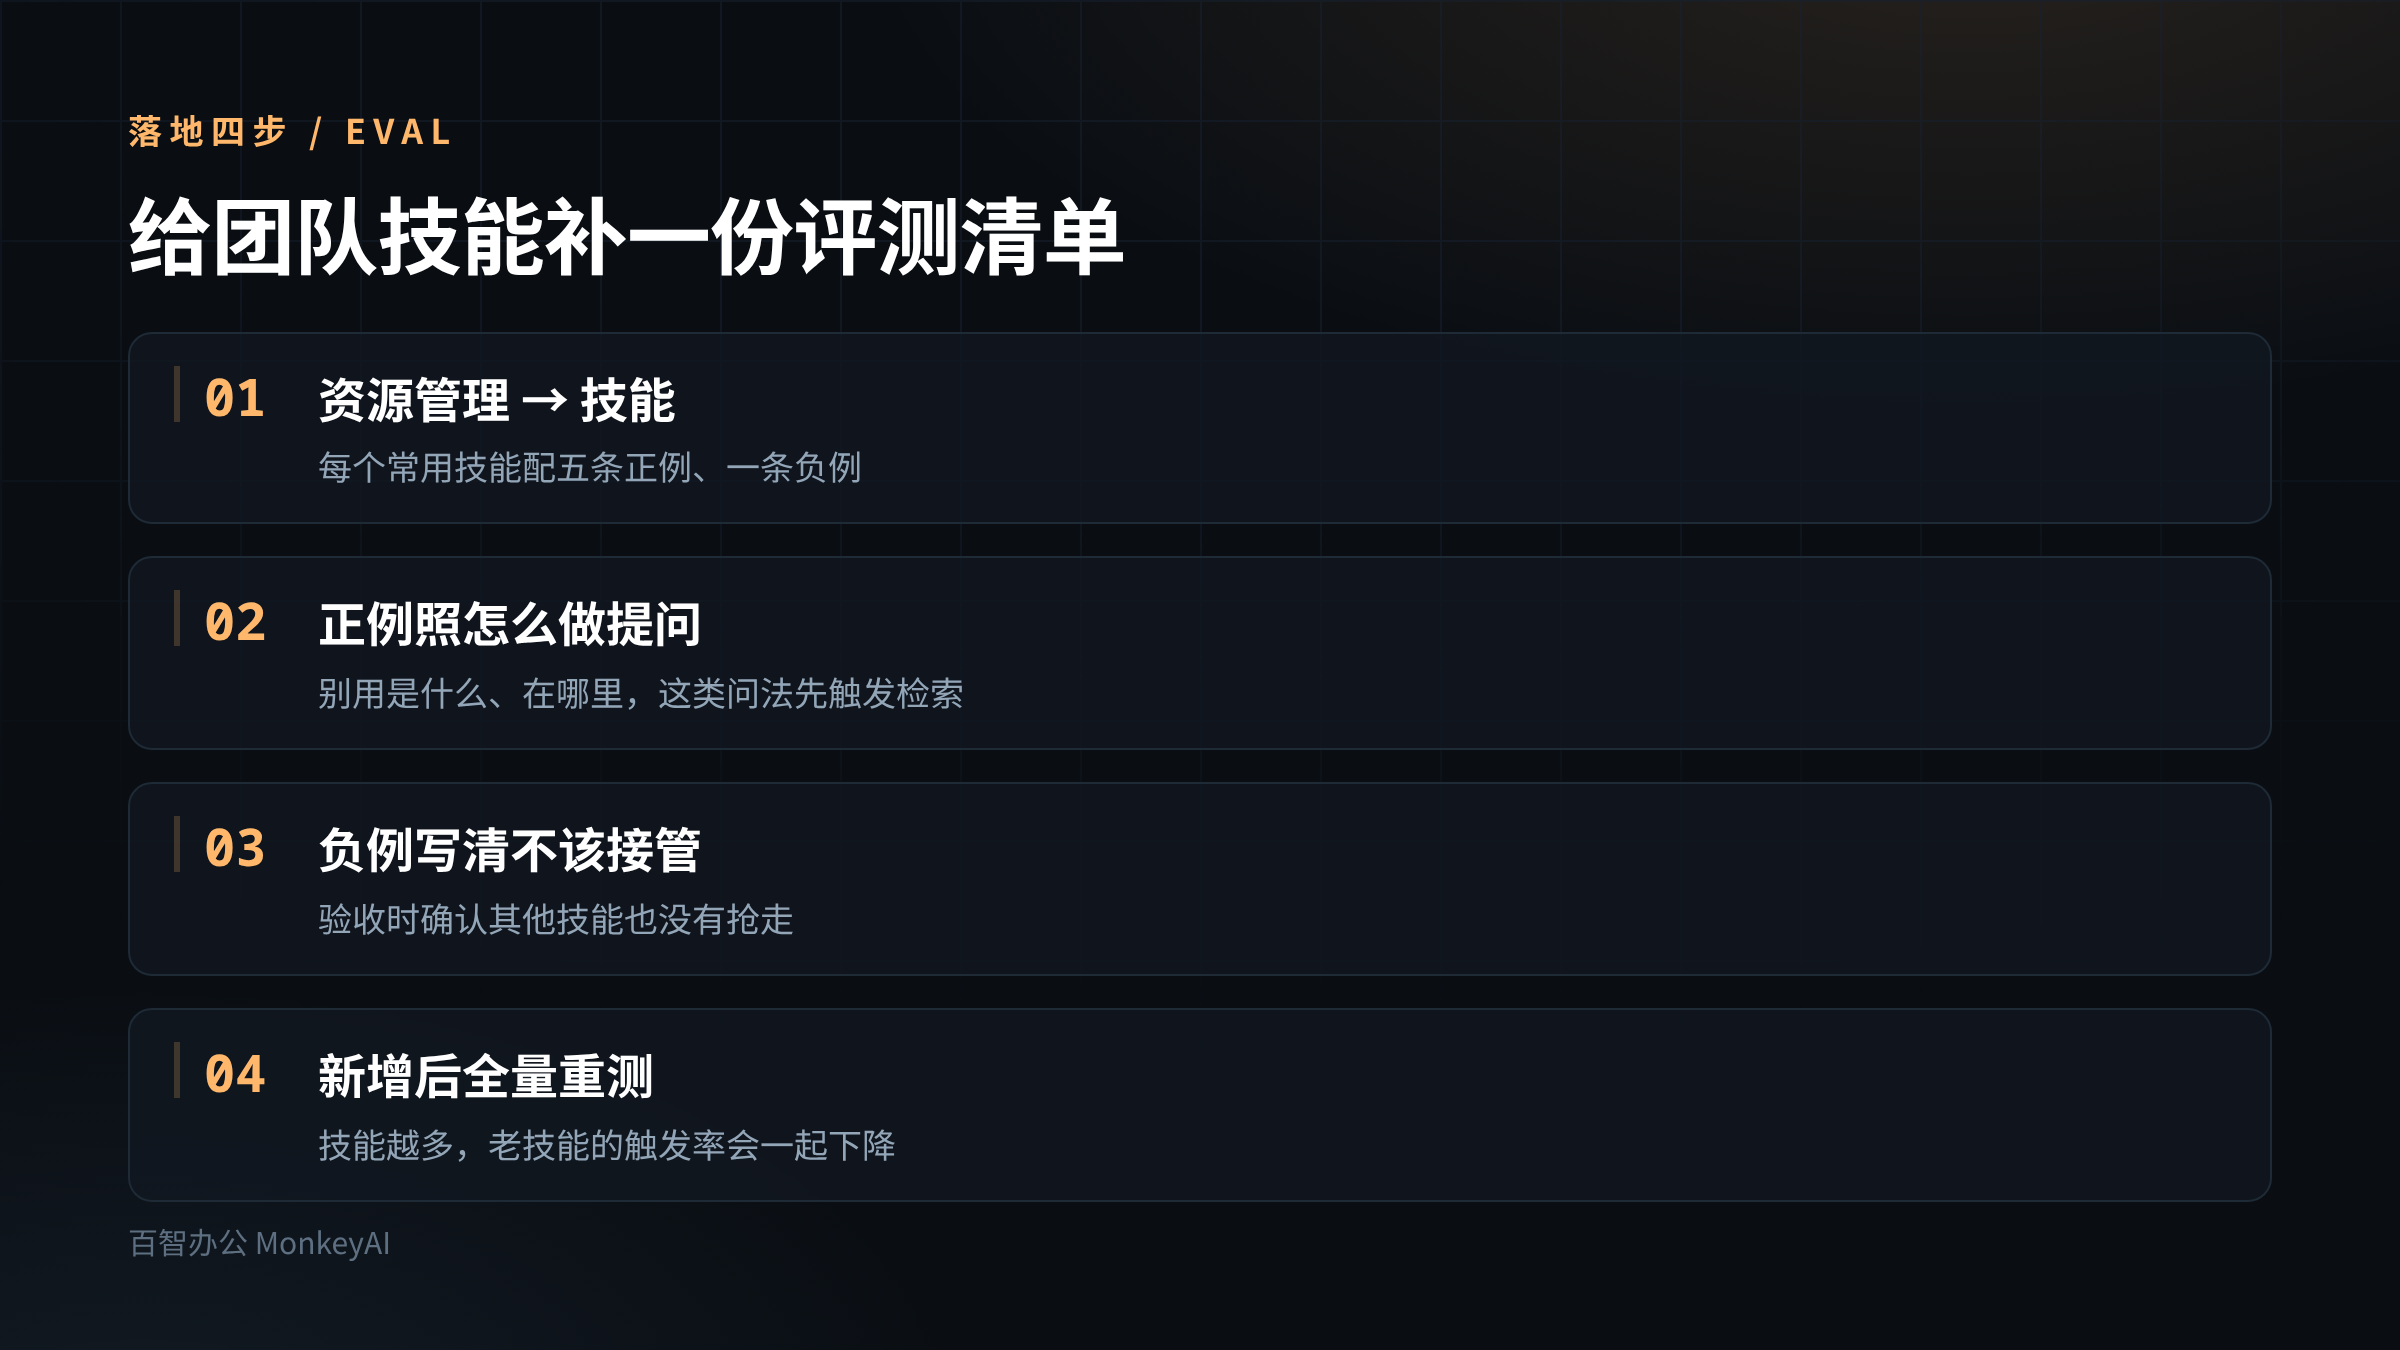
- 「资源管理 → 技能」给每个常用技能配一份评测清单:5 条正例 + 1 条负例,写在技能说明里。
- 正例照"怎么做"提问,别用"是什么"。这是首步规则给的直接结论。
- 负例写清"这件事不该由这个技能接管",验收时确认其他技能也没抢。
- 每新增一个技能,把原有技能全部重测一遍。技能多了,触发率会一起下降。
- 描述按"动词短语 + 三到四个场景"改写,别列功能清单。
- 「资源管理 → 规则」里留一条:技能输出不稳定时,先查触发是否命中,再查指令是否含糊。
第 4 条最容易被跳过。只测新技能,等于默认老技能不受影响,而实测结论正相反。
八、可以直接抄的提示词
你在帮我给一个团队技能写评测用例。按下面四段输出。
第 1 段:这个技能负责什么
· 一句动词开头的描述
· 三到四个使用场景,写成用户会说的话
· 明确写出这个技能不接管的三类任务
第 2 段:正例五条
· 每条写成真实用户的一句提问
· 提问要用"怎么做/帮我做",不要用"是什么/在哪里"
· 每条标明:模型的首个动作应该是调用这个技能
第 3 段:负例一条
· 写一个看起来相关、实际该由别的技能处理的任务
· 说明为什么这个技能不该接管
· 说明如何确认其他技能也没有接管
第 4 段:回归
· 列出这次改动会影响到的其他技能
· 给出重测顺序与判定标准
硬性要求:
- 每条用例都能在一次性会话中判定通过或失败。
- 不要用"效果更好""更自然"这类无法判定的标准。
- 最后一行写:本清单未覆盖技能之间的接力场景。
第 3 段那句"确认其他技能也没有接管",对应的是负例的集体计分方式。
九、四个坑
坑一:格式正确就当能用。
frontmatter 写坏了不报错,技能手动可开、自动永不触发。
坑二:用"是什么"测触发。
这类问法会先触发检索。测出来的低命中率,问题出在用例。
坑三:只测新技能。
技能越多,老技能的触发率越低。新增后必须全量重跑。
坑四:给描述加路径限定当加分项。
实测对话触发率减半,而且路径触发无法用提示词评测验证。
十、边界
· 91,607 星、仓库说明、七个参考服务器与语言分工、"参考实现不承诺生产就绪":GitHub 仓库页面与 README.md,2026-10-27 读取。星数会变,引用需带日期。
· 4.9MB、123 个 TypeScript 文件、25 个 Python 文件、44 份 Markdown、各服务器工具数:本地解包统计(codeload 拉取 main 分支 tar.gz),2026-10-27。
· 技能四条规则、frontmatter 解析失败的后果、1,536 与 4,000 字符预算、"新增技能会拉低已有技能触发率":仓库 AGENTS.md 的 Maintaining the skills 一节,2026-10-27。
· 首步规则、两类用例与回合预算、接力阈值 0.5、实测提问对照表、3/5→5/5 与 25/50/25→100%、paths 使触发率减半:仓库 docs/skill-authoring.md,2026-10-27。
· 11 个技能目录与各自评测用例数量、负例集体计分、正例禁止写他人名字:本地统计 .claude/skills/*/evals/evals.json,2026-10-27。
· 我没有运行 npm run skills:eval,也未在任何环境复现这些触发率;上述数字全部来自仓库文档的自述与本地文件统计,未独立验证测量过程。
十一、事实来源
· 星数、许可、仓库简介与警告:GitHub 仓库页面 modelcontextprotocol/servers 与 README.md,2026-10-27
· 七个参考服务器的语言与职责、已归档服务器清单、npx 与 uvx 用法:仓库 README.md,2026-10-27
· 技能四条维护规则、描述中禁止 $0–$9 与 $ARGUMENTS、列表预算:仓库 AGENTS.md,2026-10-27
· 首步规则与两类用例、描述模板与实测数字、注意力上限的结论:仓库 docs/skill-authoring.md,2026-10-27
· 门禁分层(内层校验、推送前门禁、CI)与 Windows 例外:仓库 docs/quality-gate.md,2026-10-27
· 技能导入入口、/技能名 调用、团队/我的/他人分享分类:官方文档《技能导入与使用》《团队资源共享》,2026-10-27 核对