10 月 17 日,DeepSeek 把 deepseek-flash 升级到 DeepSeek-V4.1-Flash-1017,官方变更日志写得很清楚:调用方式与价格保持不变。
同一份文档里还有一条更值得看的规则:错峰价是高峰价的一半。
对按工作日白天用 AI 的团队来说,这句话的潜台词是:你们绝大多数请求都落在全价时段。
一、先把三组数字对上号
官方模型页给的是这张表,单位是每百万 token:
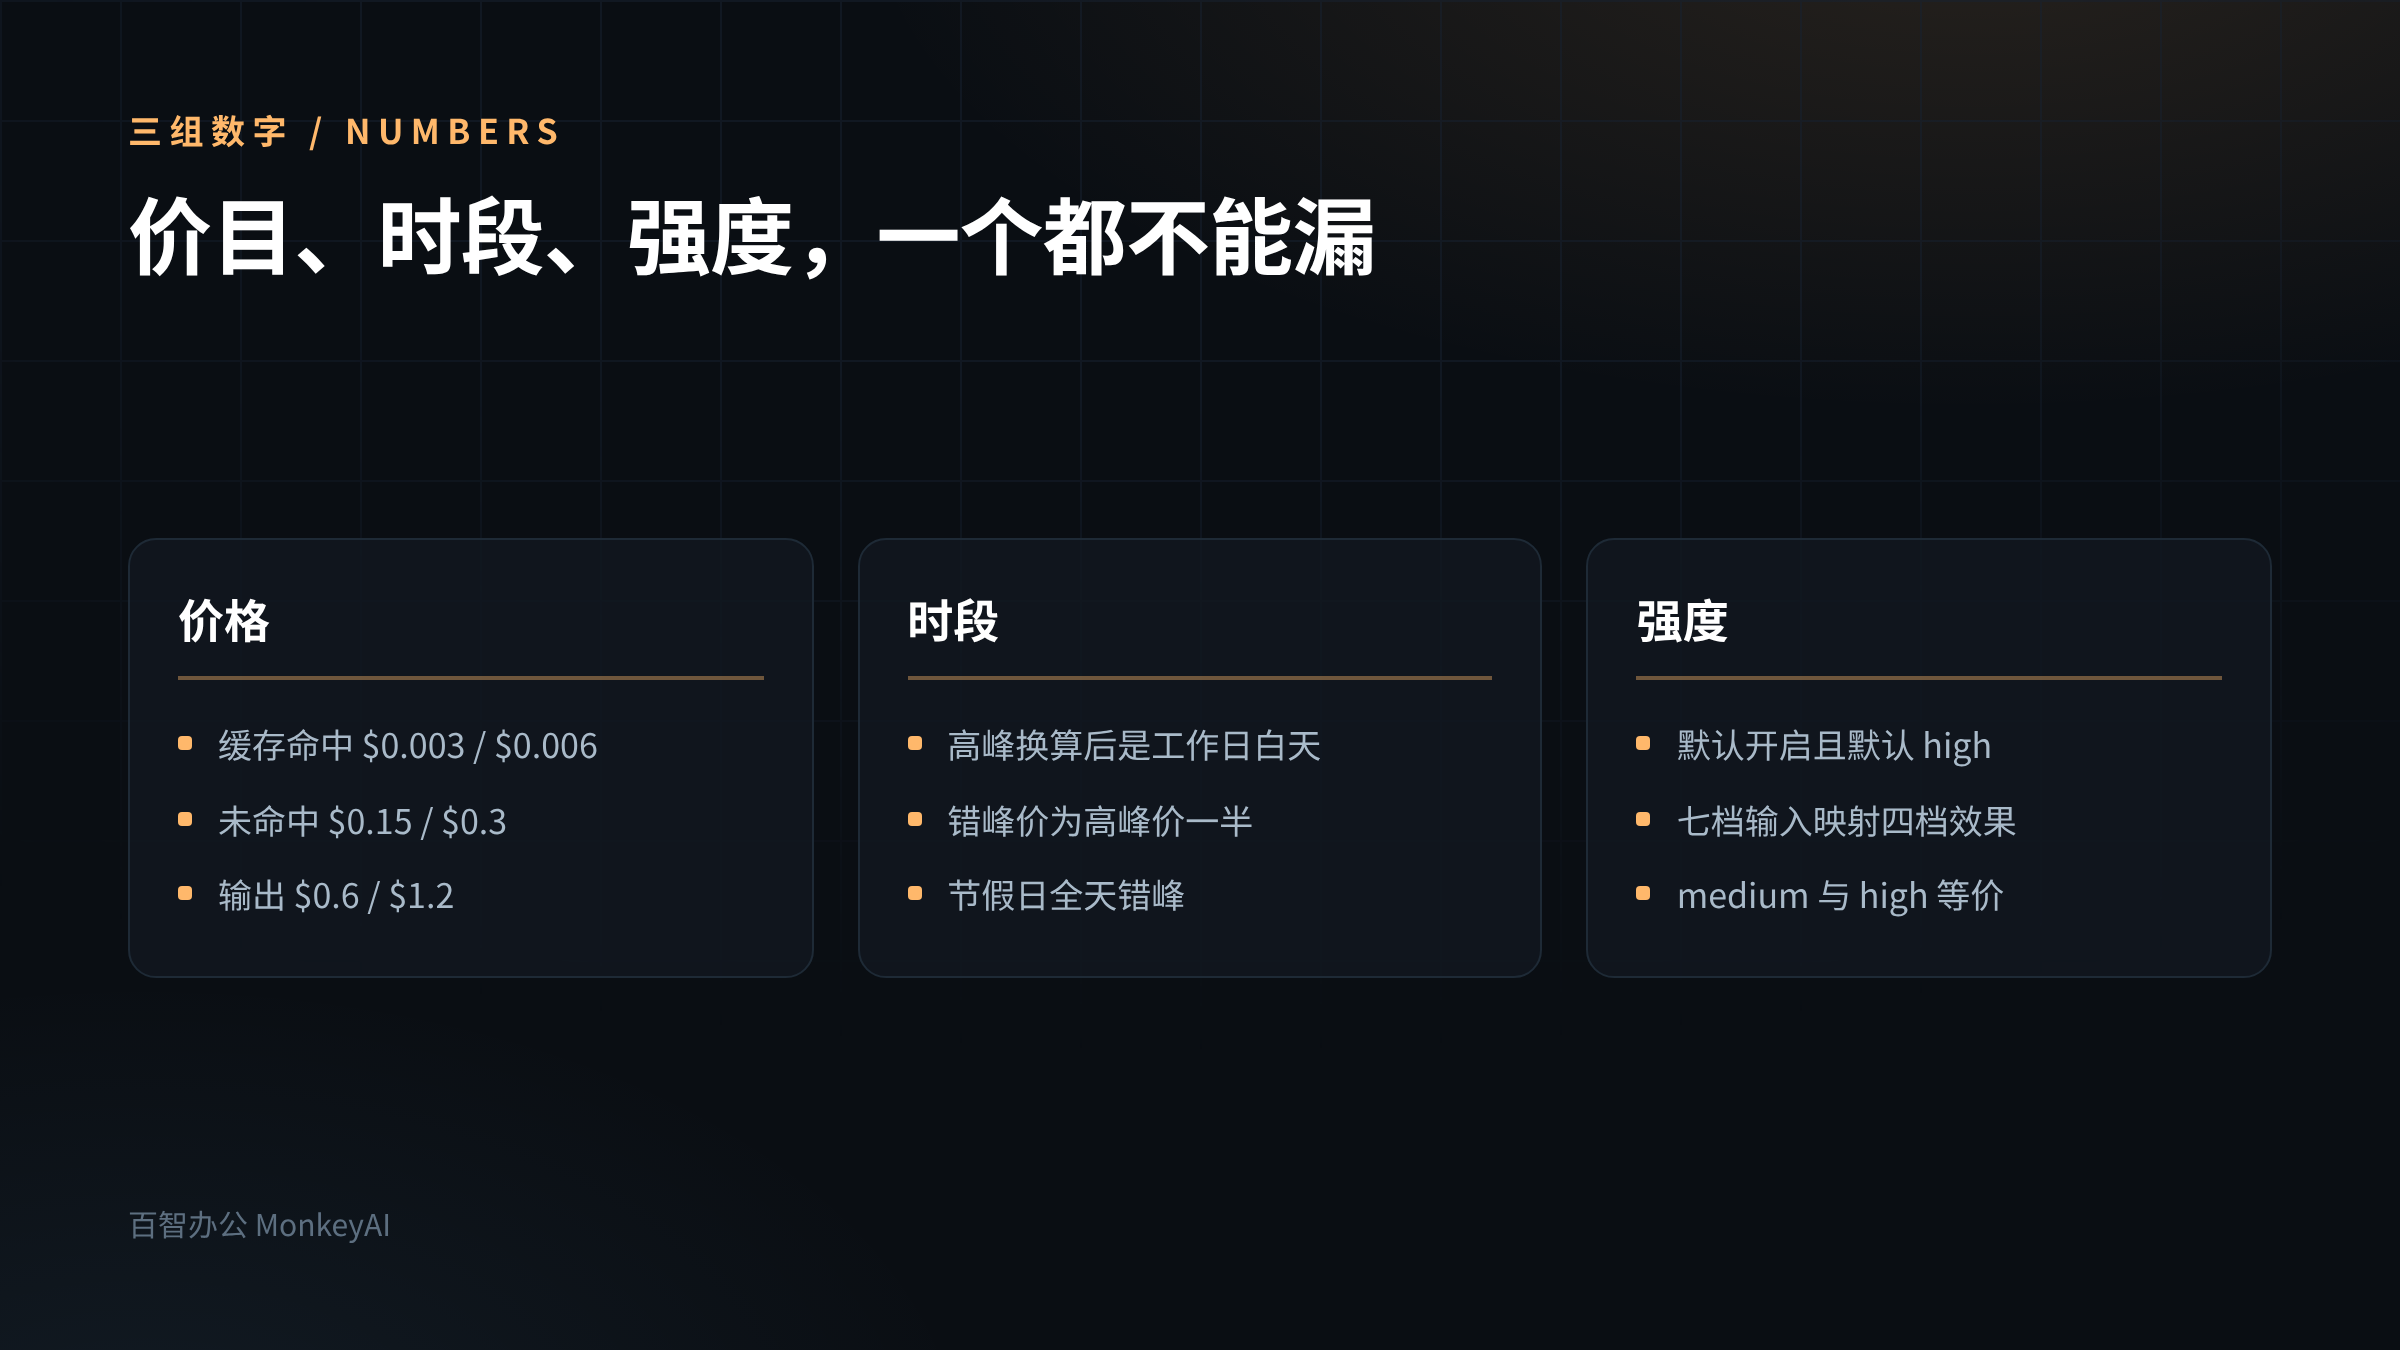
项目:输入(缓存命中);错峰价:$0.003;高峰价:$0.006
项目:输入(缓存未命中);错峰价:$0.15;高峰价:$0.3
项目:输出;错峰价:$0.6;高峰价:$1.2
同一页还给了两行能力参数:上下文长度 1M,最大输出 384K。
另一款 deepseek-v4-pro 的对应价格是缓存命中 $0.022 / $0.044,未命中 $0.66 / $1.32,输出 $1.98 / $3.96,上下文同为 1M,不支持视觉。
把这两组数放在一起看,能得出一个朴素结论:flash 的输出价是 pro 的三分之一不到。用哪个模型,先看任务需不需要 pro 那一档。
【二、高峰时段换算成北京时间,正好盖住上班时间】
官方对高峰的定义是:UTC 周一至周五 01:00–04:00 与 06:00–10:00,中国法定节假日除外。
换成北京时间,就是工作日的 09:00–12:00 和 14:00–18:00。
这条定义直接决定了成本结构:
使用场景:上班时间交互式对话;落在哪档:高峰;成本:全价
使用场景:午休时段;落在哪档:错峰;成本:半价
使用场景:晚上跑批处理;落在哪档:错峰;成本:半价
使用场景:周末整理与复盘;落在哪档:错峰;成本:半价
使用场景:法定节假日批量任务;落在哪档:错峰;成本:半价
一个团队如果只是白天让员工随手用,等于长期按两倍价付费。想拿到错峰价,办法只有一个:把不着急的活挪到非工作时段。
这条规则带来一个很实际的排班问题。日报汇总、周报生成、知识库批量入库、历史对话整理,这些任务对时效要求低,全都适合放到晚上跑。交互式问答没法挪,它就是贵的那一半。
【三、思考模式默认开着,这一项最容易被忽略】
官方文档写明:思考模式默认开启,默认强度是 high。
强度参数有一张映射表,值得抄下来:
你填的值:minimal;实际生效:low
你填的值:low;实际生效:low
你填的值:medium;实际生效:high
你填的值:high;实际生效:high
你填的值:xhigh;实际生效:high
你填的值:max;实际生效:max
你填的值:ultra;实际生效:max
七档输入只映射出四档效果。填 medium 和填 high 是一回事,填 xhigh 也是 high。
这意味着两件事:
第一,调参空间比参数名看起来小。想要真正降档,只能填 low 或 minimal,其余都在 high 及以上。
第二,默认值就是 high。一个没做任何配置的团队,拿到的是偏高的推理强度,输出更长、耗时更久、账单更高。
同一个模型的另一条限制更容易踩:思考模式下 temperature、presence_penalty、frequency_penalty 三个参数不生效。
很多人习惯性把 temperature 设成 0.2 以求稳定,在思考模式下这个设置被忽略,模型仍在按自己的采样逻辑走。以为调了参数、实际没调,这类错觉在排查输出不稳定时排查时最耗精力。
【四、缓存默认开着,命中要靠设计】
官方说明是上下文缓存默认开启、无需改代码,但命中条件有讲究。
每个缓存前缀是一个独立的完整单元,后续请求必须完整匹配某个前缀单元才能命中。持久化发生在三类位置:用户输入的结尾、模型输出的结尾,以及系统检测到的多请求公共前缀。
翻译成操作层面的规则:
- 把稳定的部分放前面。系统提示词、规则、知识库片段固定在最前,用户问题放最后。
- 别在开头插时间戳。加了当前时间,前缀每次都不一样,缓存永远不命中。
- 别随意调整提示词顺序。改一个字,后面的整段都失效。
缓存命中价与未命中价差 50 倍($0.003 对 $0.15)。这个倍数意味着,一次前缀设计失误的代价,比换模型大得多。
五、并发上限和账号级隔离
flash 的并发上限是 2500,pro 是 500,按账号计算,与用几个 API Key 无关。超出会返回 429。
如果团队共用一套账号,这件事必须提前算:2500 个并发听起来很多,但一个批量任务如果开了几十个并行子任务,再乘上多个成员同时使用,很容易触顶。
文档还给了一个 user_id 参数,作用是三件事:内容安全隔离、KVCache 隔离、调度隔离。
对团队场景来说,第二项最实用。给每个成员或每个部门传不同的 user_id,缓存不会互相串,隐私边界也更清楚。
六、在百智办公里怎么配
这些规则要落到配置里才算数。
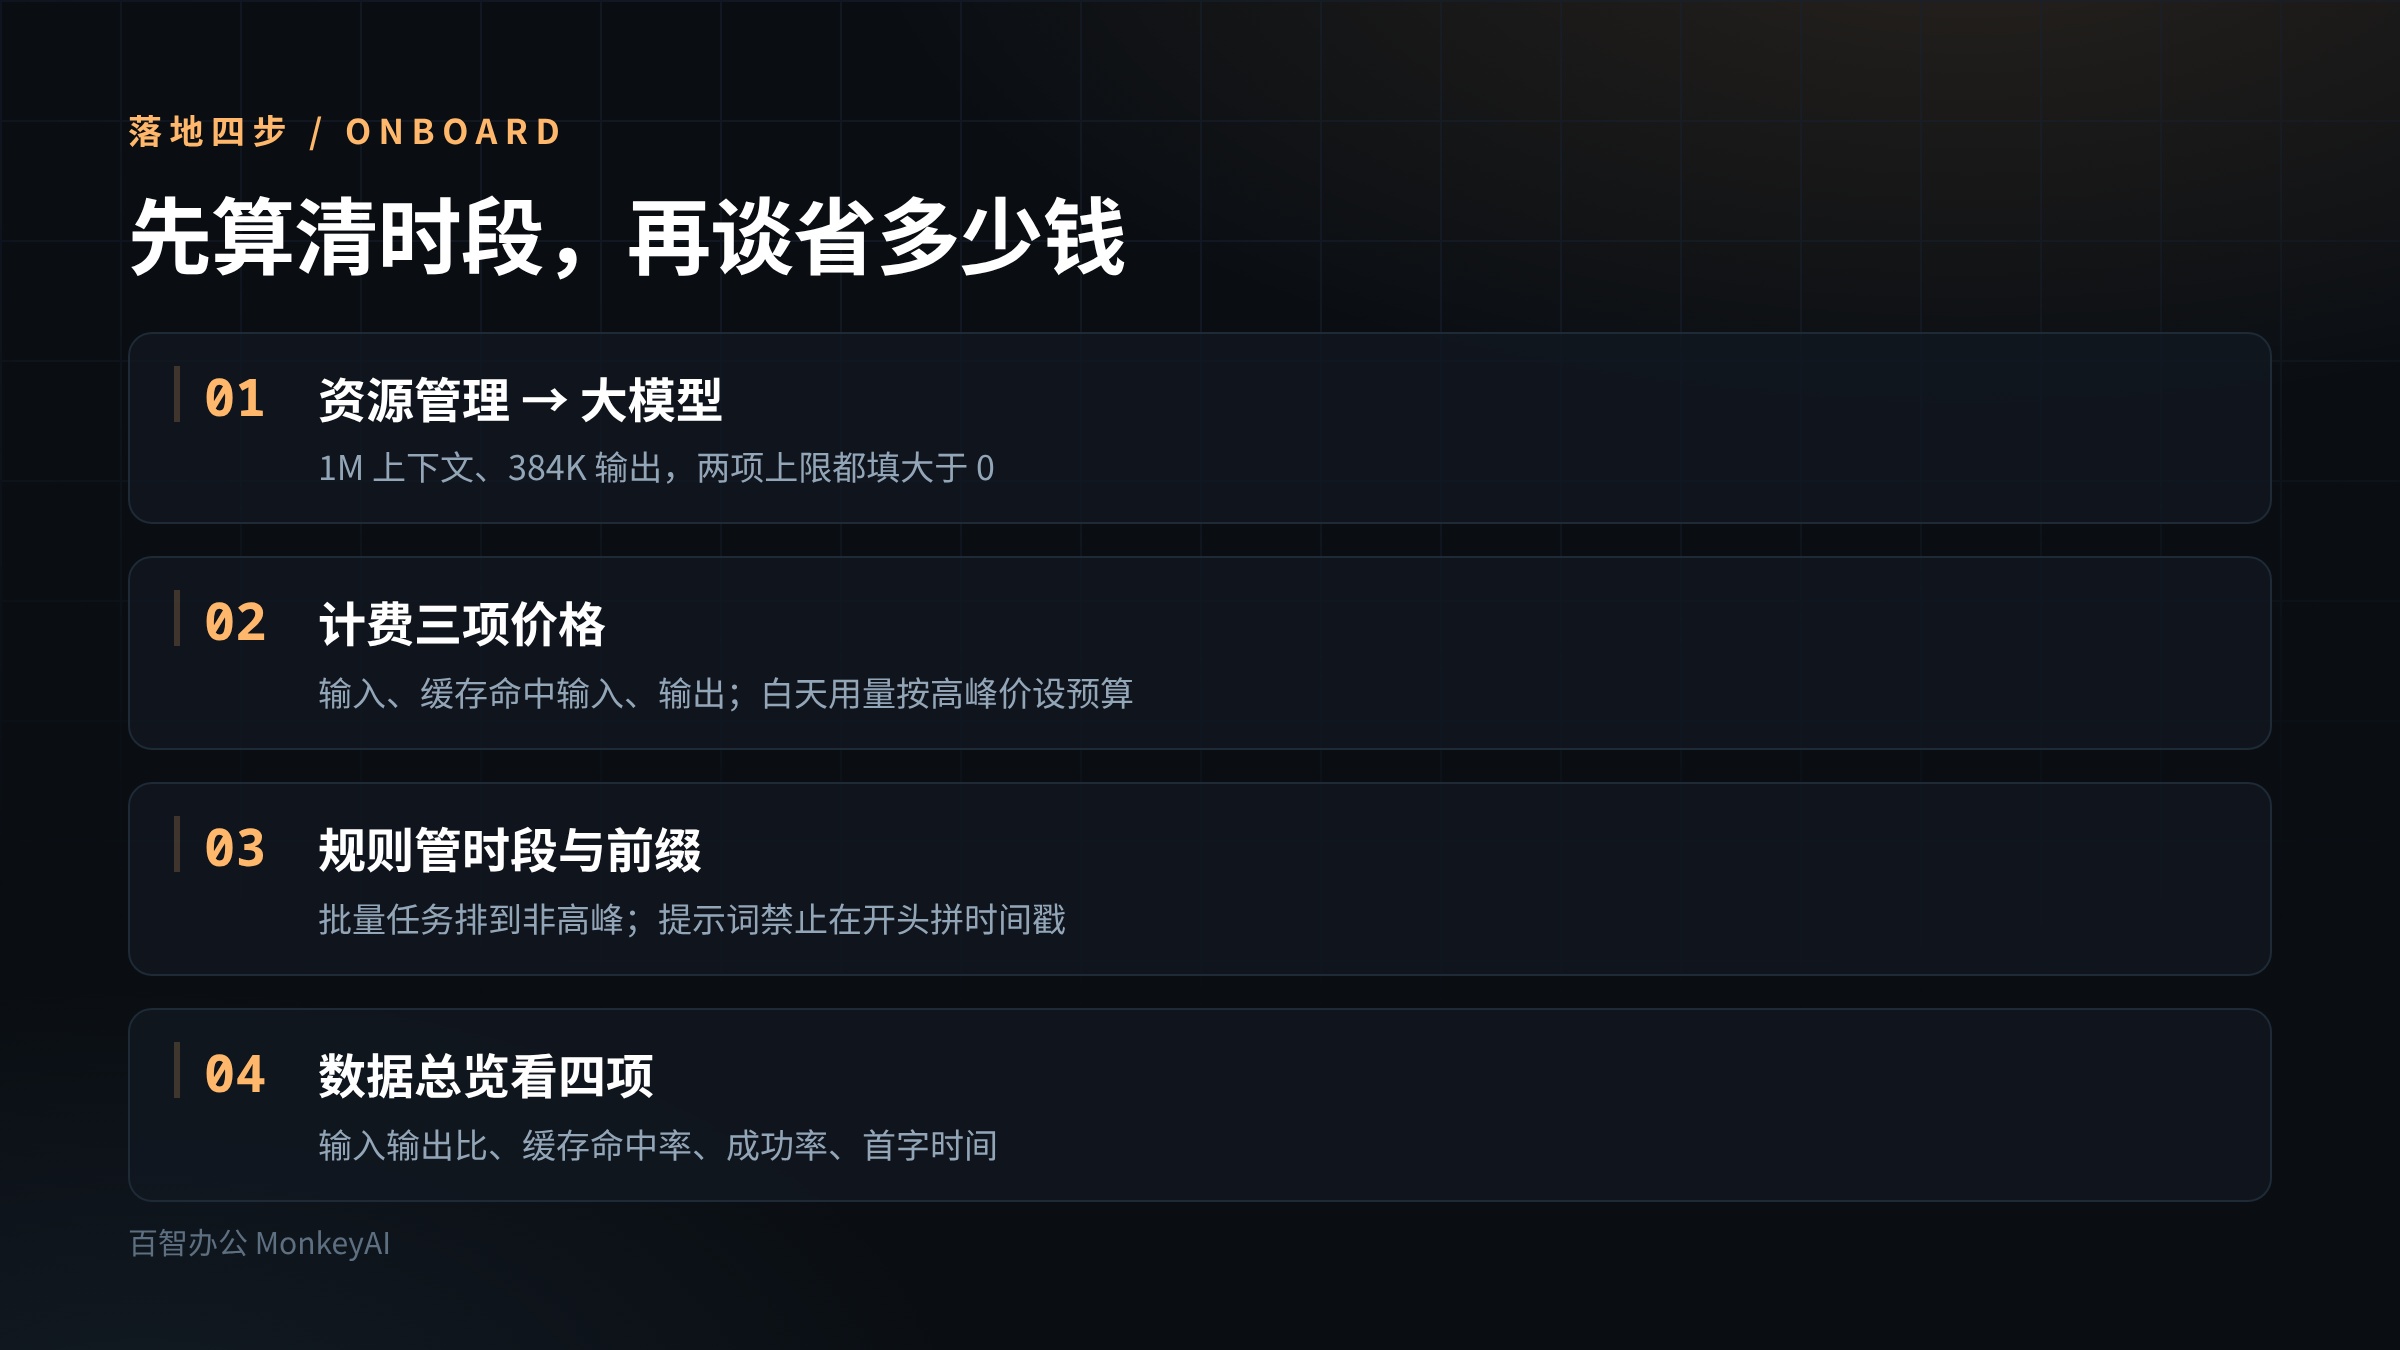
- 「资源管理 → 大模型」新增一条:接口地址 deepseek-flash,上下文长度 1000000,最大输出 384000。两项上限都填大于 0 的值。
- 「计费设置」把三项价格按官方表填进去:输入、缓存命中输入、输出。错峰与高峰两个价差一倍,如果团队大部分用量在白天,按高峰价设预算更稳妥。
- 「资源管理 → 规则」加两条:
- 非交互任务(周报、批量整理、知识库入库)默认排到非高峰时段执行;
- 提示词模板固定前缀结构,禁止在开头拼接时间戳与随机 ID。
- 「资源管理 → 技能」给批处理任务单独做一个技能,把思考强度显式设为 low,交互式问答保留默认。
- 「数据总览」每周看四项:输入输出比、缓存命中率、成功率、首字时间。缓存命中率是判断前缀设计对不对的直接指标。
- 分发范围按分组下发。客服组偏交互、数据组偏批处理,两组的预算和使用时段应该分开设。
第 5 步的四项指标里,缓存命中率最容易被忽略,也最能省钱。它低于预期,先查提示词前缀,再查模型本身。
七、可以直接抄的提示词
你在帮我做一次模型成本复盘。数据只能来自我提供的账单与调用记录,不要估算。
输入:一段时间内的调用记录(含时间戳、输入 token、输出 token、缓存命中 token、模型名)。
请输出四块:
-
时段分布
· 按高峰 / 错峰分组统计调用次数与 token 数。
· 换算成北京时间,标出哪些小时调用最集中。
· 如果高峰时段占总量超过 70%,单独提示"可迁移任务"。 -
可迁移任务
· 列出所有非实时任务(报表、汇总、批量整理、入库、归档)。
· 逐个估算迁移到错峰时段能省多少(按输出价差一倍计算)。
· 标出迁移的阻碍(依赖人工触发、依赖当日数据等)。 -
缓存效率
· 计算缓存命中 token 占输入 token 的比例。
· 命中率低于 30% 时,列出三条可能的成因,按可能性排序。
· 不要给"优化提示词"这种笼统建议,要指出具体位置。 -
强度配置
· 列出当前使用的思考强度,以及它实际映射到哪一档。
· 标出哪些任务用了高于需要的强度。
硬性要求:
- 每个数字标注来源与时间范围。
- 缺失字段写"未提供",不要用行业均值替代。
- 最后一行写:本复盘只覆盖提供的记录,未考虑订阅制与包月方案。
八、四个坑
坑一:以为降价就是省钱。
输出价降了,但如果思考强度仍是默认的 high、缓存又没命中,账单可能一点没动。价格表和实际支出之间隔着配置。
坑二:拿 medium 当"中间档"。
它实际映射到 high,和填 high 没有区别。想降成本得填 low 或 minimal。
坑三:在系统提示词开头拼时间。
这是缓存失效最常见的原因。前缀一变,整段重新计费,命中价与未命中价差 50 倍。
坑四:忽略峰谷时段换算。
官方按 UTC 定义高峰,直接按字面理解会错开 8 小时。换算成北京时间后,高峰正好是上班时段,这个结论会改变你的任务排布。
九、边界
· 1M 上下文、384K 最大输出、两档模型的三组价格、flash 不支持的部分能力:官方文档《Models & Pricing》,2026-10-27 读取。
· 错峰价为高峰价一半、高峰时段为 UTC 周一至周五 01:00–04:00 与 06:00–10:00、中国法定节假日除外:同一页脚注,2026-10-27。
· 思考模式默认开启且默认 high、七档强度到四档的映射、思考模式下三个采样参数不生效:官方文档《Thinking Mode》,2026-10-27 读取。
· 缓存默认开启、前缀单元需完整匹配、三类持久化时机:官方文档《Context Caching》,2026-10-27 读取。
· 并发上限 2500 / 500、按账号计算、超限 429、user_id 三项隔离作用:官方文档《Rate Limit & Isolation》,2026-10-27 读取。
· V4.1-Flash-1017 于 2026-10-17 升级、调用方式与价格不变:官方文档《Change Log》,2026-10-27 读取。
· 我没有用真实账单验证峰谷切换后的实际差额,也没有跑并发压测;本文的换算与推演基于官方文档口径。
十、事实来源
· 模型版本、上下文 1M、最大输出 384K、两档模型价格与并发上限:读取
· 错峰价与高峰价关系、高峰时段定义与例外:同一页面脚注 (2),2026-10-27
· 思考模式默认开启与默认强度、强度映射表、采样参数限制:· 上下文缓存的默认开启、前缀单元匹配规则与持久化时机:· 并发上限、429、user_id 的内容安全 / KVCache / 调度三项隔离:· V4.1-Flash-1017 升级日期与"调用方式与价格不变":· 1 个汉字约 0.6 token、1 个英文字符约 0.3 token、实际用量以返回 usage 为准:· 大模型配置项与两项上限、计费三项价格、数据总览四项指标、技能与规则、三档分发:官方文档《团队资源配置与分发》《计费与额度管理》,2026-10-27 核对