Kimi K3.1 Pro 上线第三天,社交平台上同时出现两种评价:一种说"强得离谱",一种说套餐里用起来很差。
两边都没有给出可复核的评测方法。真正能拿来做决定的,是官方文档里的参数和接入条件。
先放下谁对谁错,只讲一件事:如果你打算把它接进团队,有四个地方会先绊住你。
一、先把官方数字摆出来
官方文档给出的口径是:3 万亿级参数,100 万 token 上下文,官方把它放在自家模型序列的顶配位置。同时推出高速版 K3.1 Pro Highspeed,同等智能,输出速度约 2 到 3 倍。完整权重计划在 11 月 4 日前发布。
三个可对照的分数:
测试项:Terminal-Bench 4.0;Kimi K3.1 Pro:65.7%;对照:GPT-6 Astra 58.2%,Claude Opus 5.5 66.4%
测试项:Kimi Code Bench 3.0 Long-horizon;Kimi K3.1 Pro:61.2%;对照:上一代 K3 为 55.95%
测试项:上下文窗口;Kimi K3.1 Pro:1,048,576 tokens;对照:K2 系列为 262,144
结论写得很克制:在代码、Agent 和知识类基准上达到或接近头部闭源模型的水平。这句话本身就在划边界,它没有说全面超越。
【二、第一件:协议选错,能保存但调不通】
这是接入时最先踩的坑。
Kimi 同时兼容三种 API 格式,各自使用不同的 base_url:
兼容协议:OpenAI Chat Completions;base_url:兼容协议:OpenAI Responses;base_url:兼容协议:Anthropic Messages;base_url:
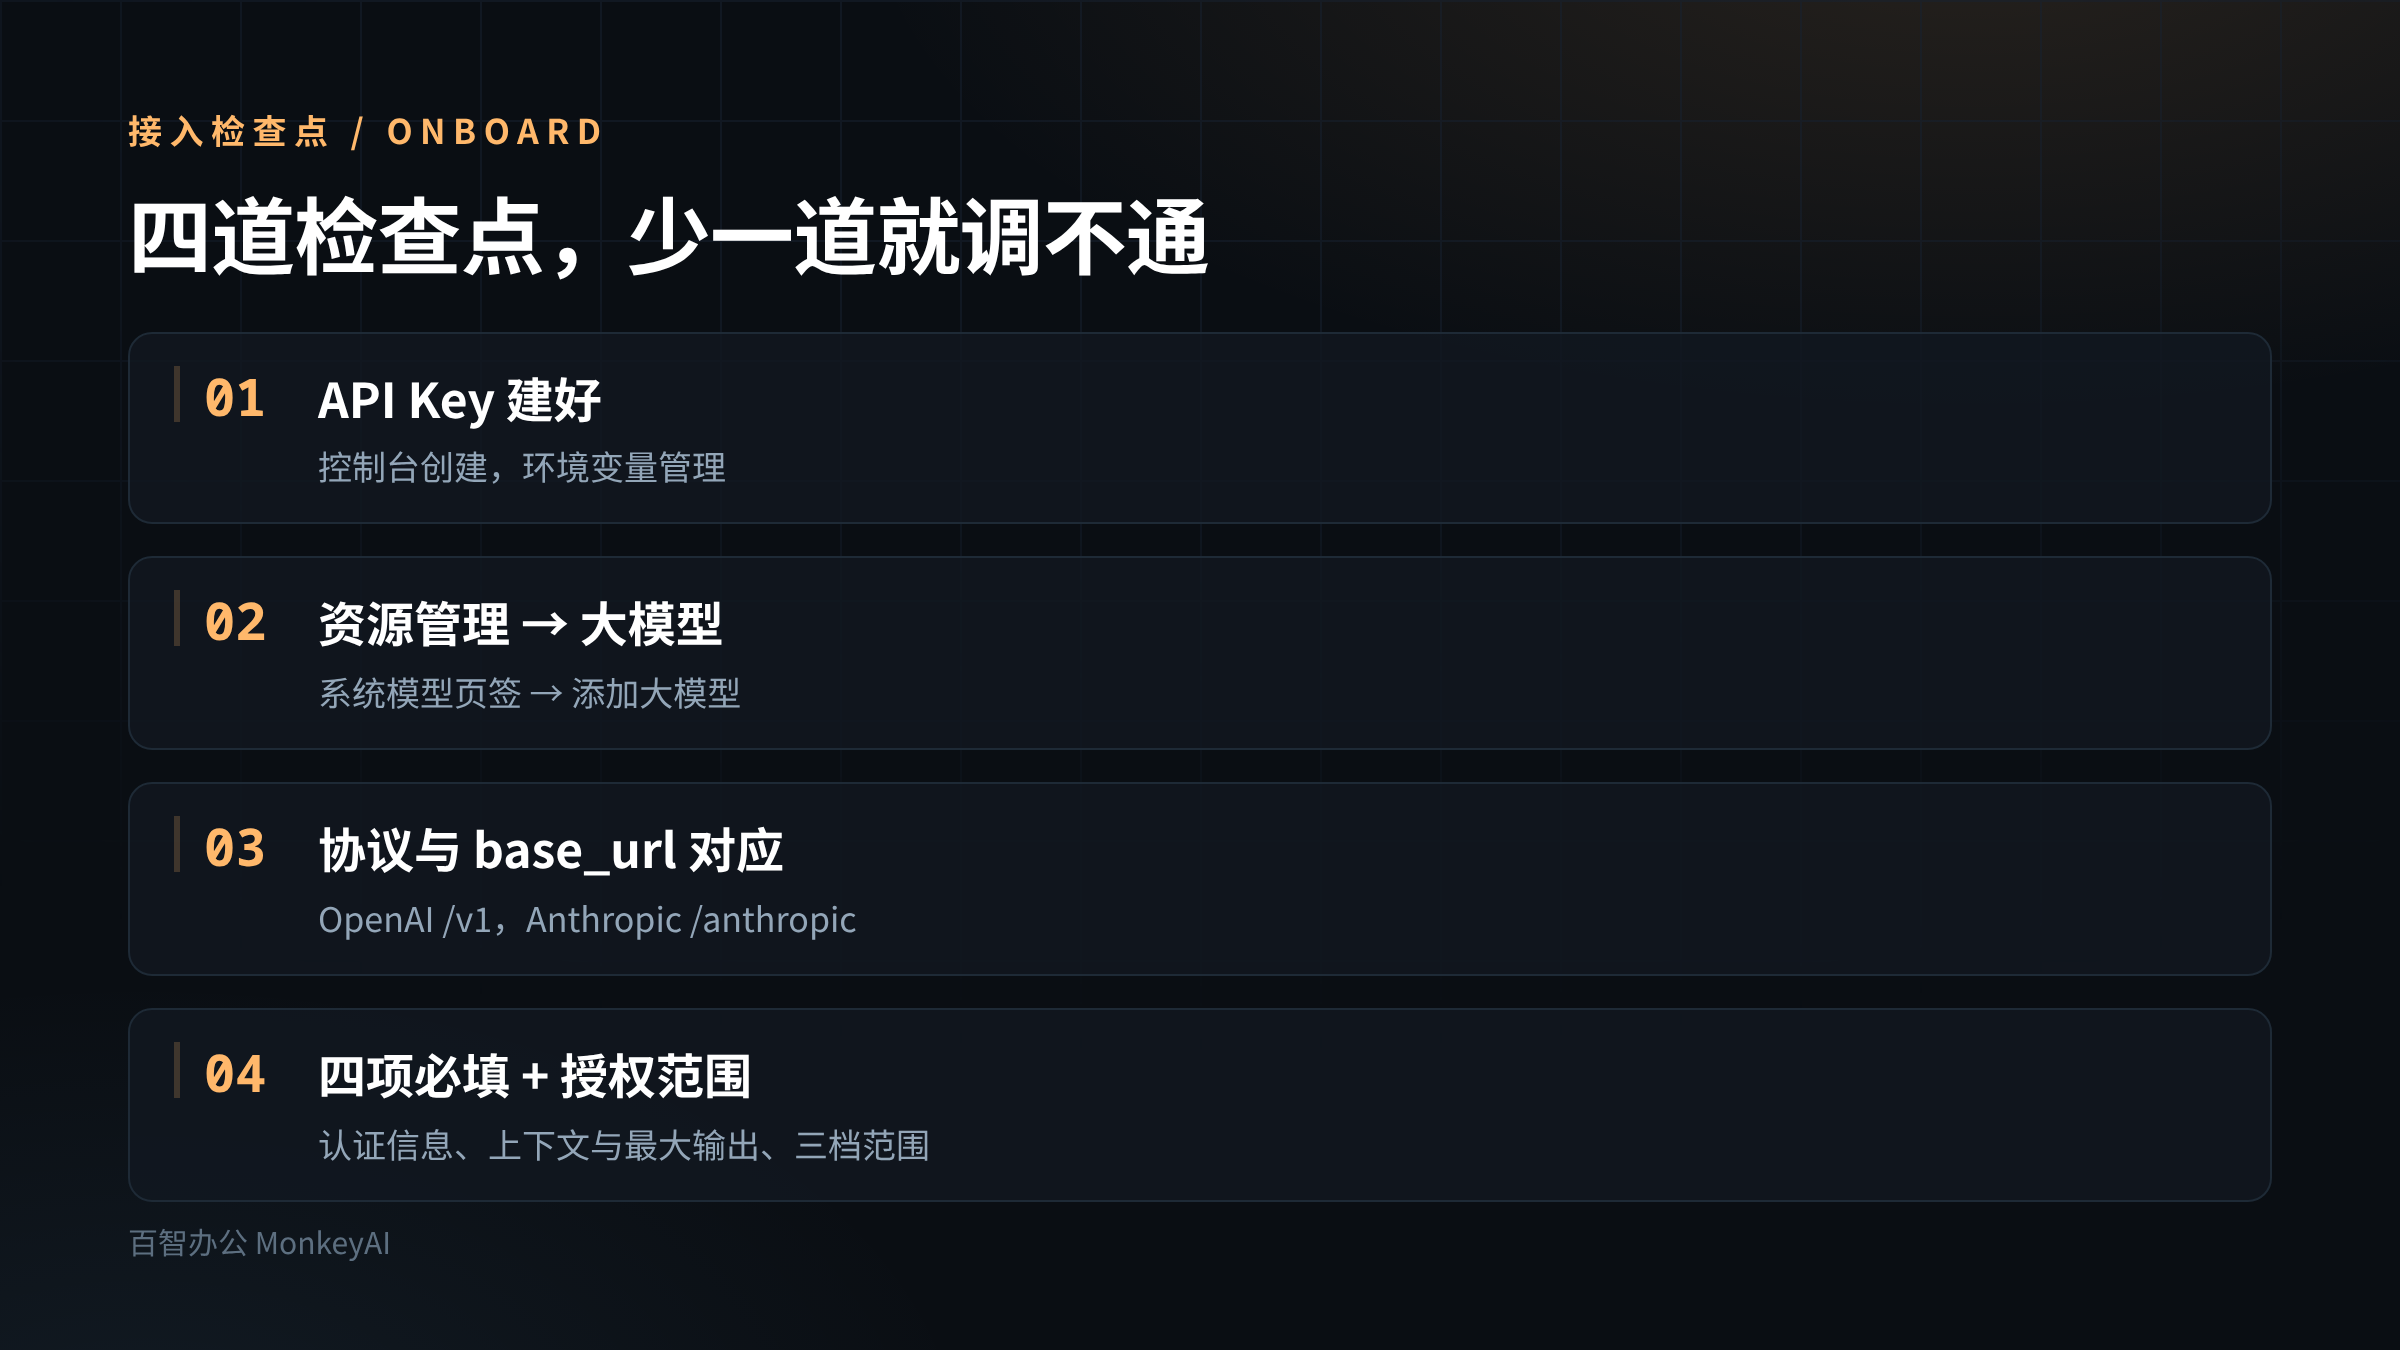
在百智办公后台「资源管理 → 大模型」添加时,协议一栏要和 base_url 对应。选了 Anthropic 原生却填 /v1 地址,表现是保存成功、调用报 400。
这个错误很难自查,因为后台不会拦你,只有第一个成员发起任务时才会暴露。
【三、第二件:缓存是自动开的,价格要单独设】
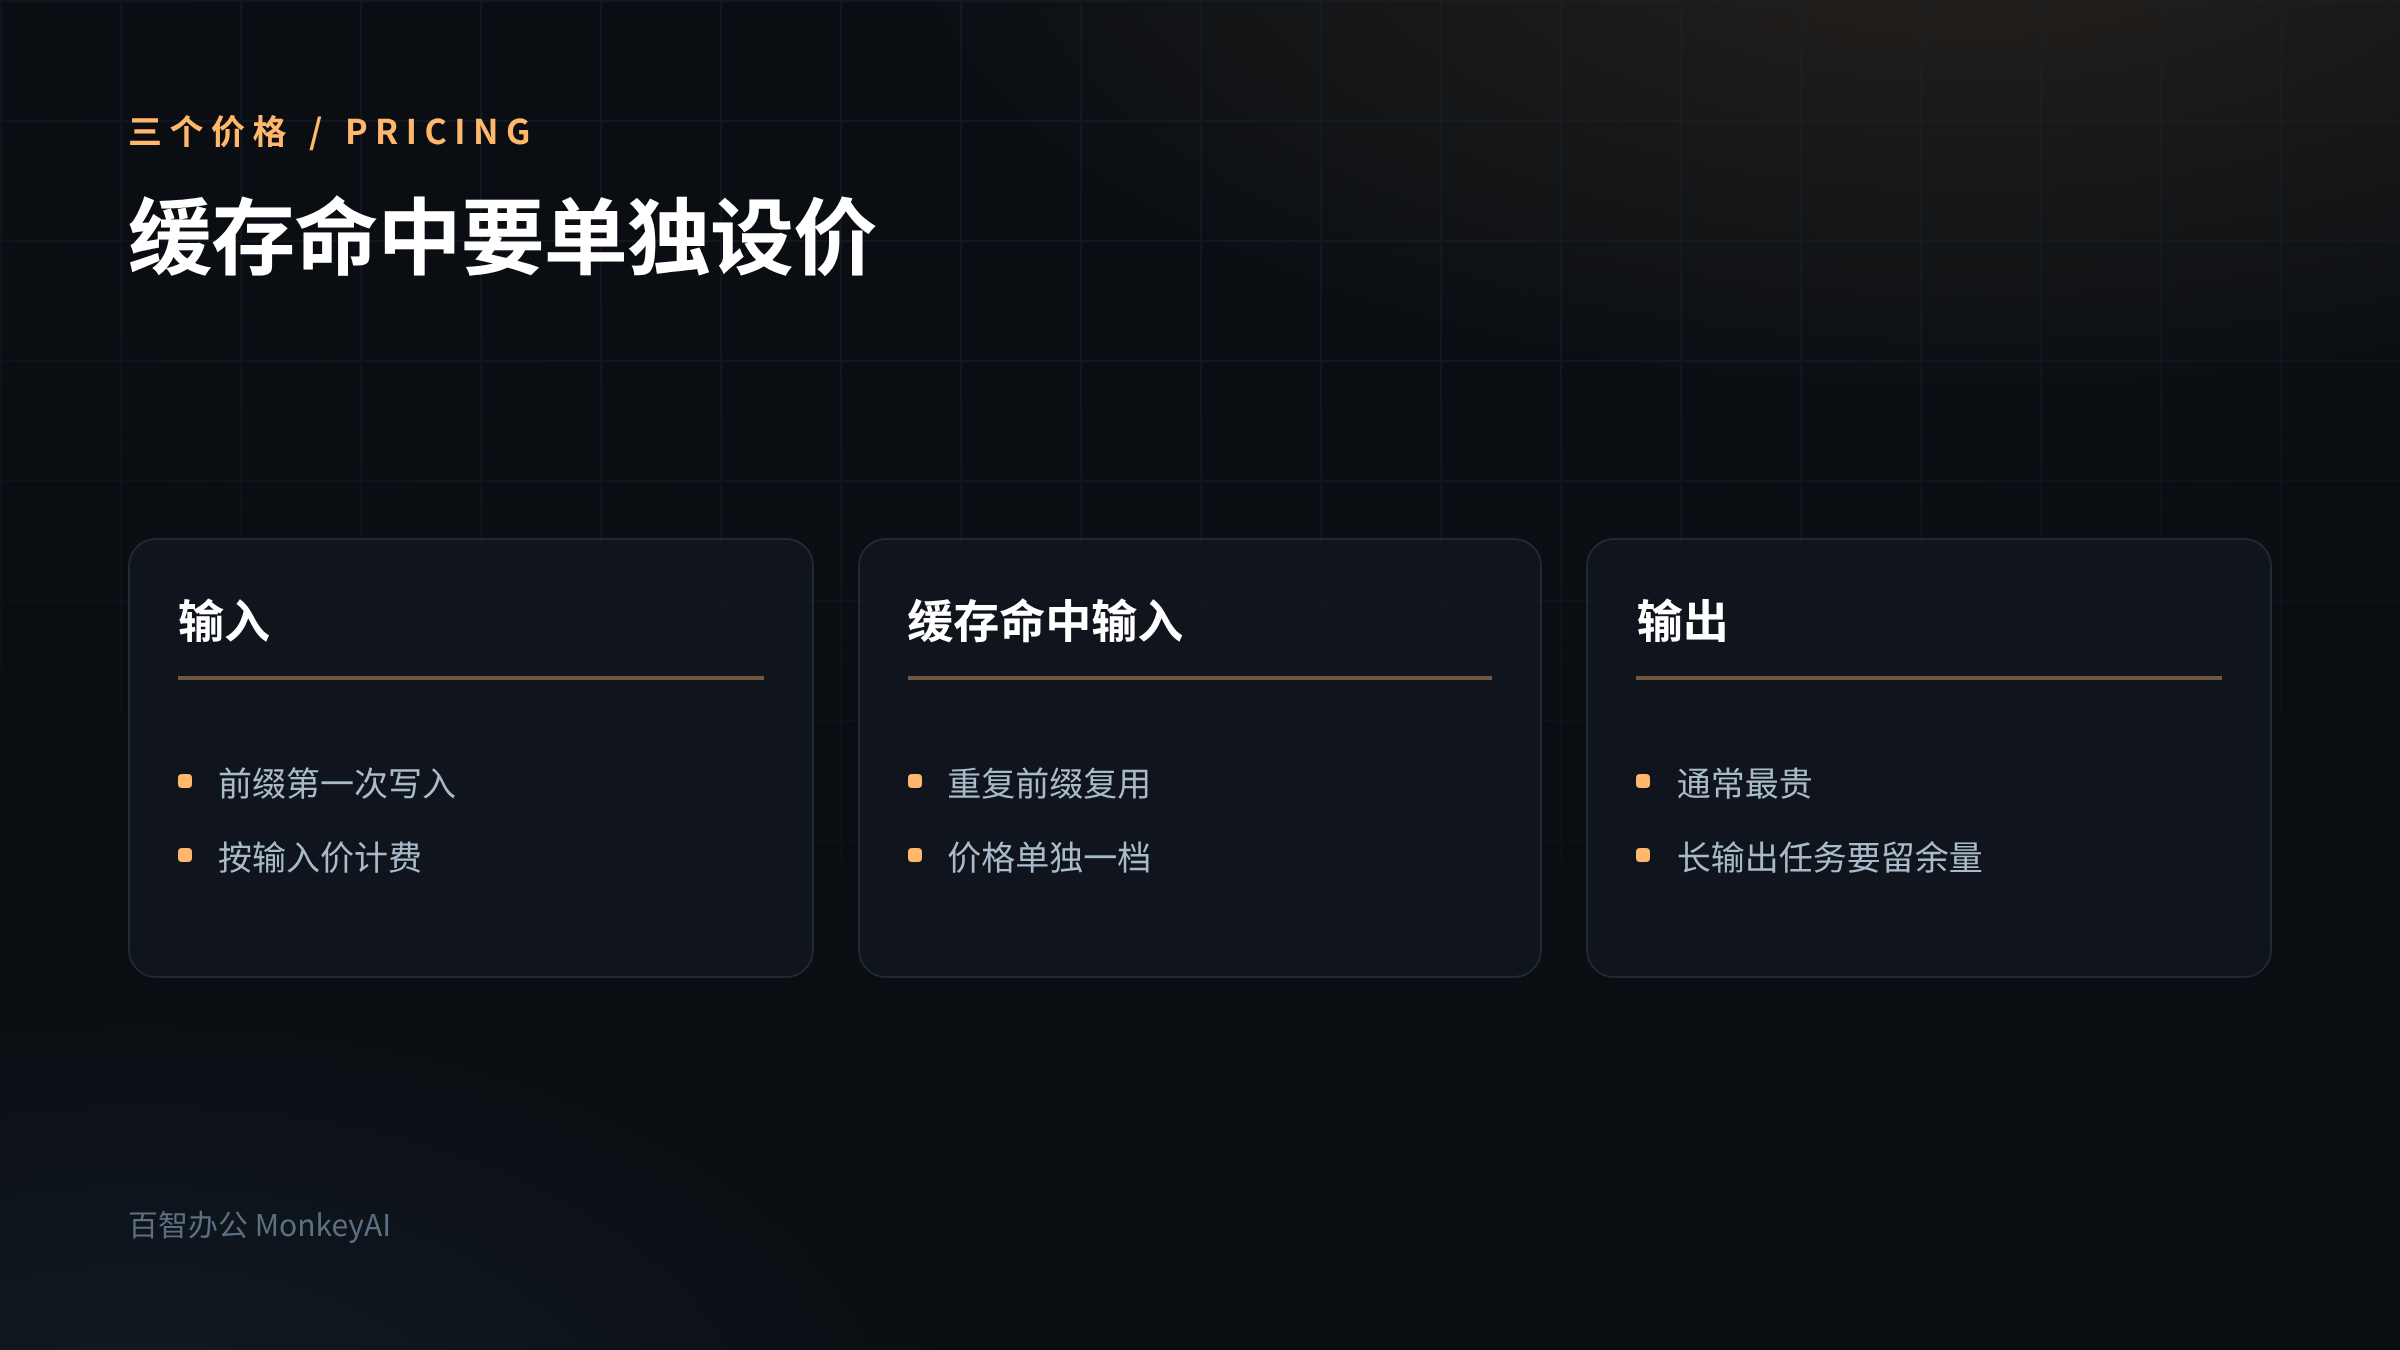
K3 系列对重复的请求前缀自动启用上下文缓存计费,TTL 默认 5 分钟。缓存写入按 TTL 单独计费,缓存命中的输入按另一个价格算。
这意味着两件事。
对上游:你以为省了钱,其实省的是"缓存命中"那部分,首次写入照样计费。前缀一变,缓存就失效。
对团队:后台「计费设置」里,模型价格要分别填输入、缓存命中输入、输出三项。只填输入和输出,缓存命中那一段就没有内部计价依据,对账时会出现"上游说用了缓存、你的账单没体现"。
更实际的一点:缓存命中率在「数据总览」里有单独指标。这个数字能直接回答一个问题:团队的任务模式到底有没有复用前缀。
如果缓存命中率长期接近 0,说明每次任务都在换上下文,省不下钱,这时候该优化的是任务写法,换更便宜的模型解决不了这个问题。
【四、第三件:思考深度默认是最高档】
K3.1 Pro 始终进行推理,通过顶层 reasoning_effort 控制强度,取值 low / high / max,默认 max。
默认最高档的意思是:你不配置,每次任务都按最大深度跑,耗时和 Token 消耗也按最大算。
在客户端里对应「设置 → 助手配置 → 模型」中的思考深度选项,支持低、中、高档,可结合任务类型调整。
一个务实的分配方式:
任务类型:合同条款比对、方案评审;建议档位:高档;理由:需要多步推理,错一步代价高
任务类型:周报整理、格式改写;建议档位:低档;理由:主要是重写,不需要长链推理
任务类型:字段抽取、批量分类;建议档位:中档;理由:需要一点判断,但不必穷举
同一批任务用 max 和 low 各跑一遍,看输出质量和耗时差距。差距不大就降到低档,这是最容易拿到的一笔成本优化。
【五、第四件:K2 要下线,别把存量任务压在老模型上】
官方公告写得很明确:K2 系列从 2026 年 10 月 31 日起停止向新注册用户开放,计划 12 月底下线全部 K2 系列模型。
对团队的含义:后台里如果还挂着 K2 系列的模型配置,年底前必须迁移。迁移涉及三件事:
- 大模型配置里换模型 ID。
- 引用了这些模型的技能和专家,逐个验证是否还能跑通。
- 历史任务里的会话不受影响,但重跑的结果可能和之前不一样。
这件事拖到 12 月再做,会撞上年度收尾,建议现在就把清单列出来。
六、接入路径
管理员侧六步:
- 拿到 API Key(控制台创建,建议用环境变量管理,不要写进配置文件)。
- 进入「资源管理 → 大模型」,「系统模型」页签点「添加大模型」。
- 类型选文本模型,协议选 OpenAI 兼容或 Anthropic 原生,与 base_url 对应。
- 填接口地址、API 密钥、模型名称。
- 上下文大小和最大输出 Token 必须大于 0,填 0 或留空保存会失败。
- 设置授权范围:全员、指定分组、指定用户。
成员侧:客户端「设置 → 助手配置 → 模型」刷新,能看到团队模型即接入成功。
七、三组任务,验证值不值
不要用"你好"测。下面这段可以直接抄:
你是我的模型验证助手。我会给你三类真实材料,请逐项完成。
任务一:从这份 30 页 PDF 里提取 12 个字段,输出 markdown 表格;字段缺失写"未提供",禁止推测。
任务二:读这份 Excel 的 200 行明细,找出金额与日期互相矛盾的记录,按矛盾类型分组,每组给出判断依据。
任务三:基于前两项结果写 300 字结论,每个数字后面用括号标出来源文件名。
硬性要求:
- 不确定的地方写"无法确认",不要补全。
- 每完成一项,报告你实际使用的上下文规模。
- 最后输出自检表:哪几项你觉得结果不稳定,原因是什么。
三组任务分别覆盖长文档、结构化数据、跨材料综合。同一份材料换模型跑,对比字段准确率、结论里的数字有没有编、总耗时。
这比看榜单有用,因为你的材料就是你团队的真实分布。
八、边界
· 官方基准是官方自己跑的,测试集和条件未完全公开,只能当参考。
· "3 万亿级参数"没有公布激活参数,推理成本的推算不能按总参数算。
· 社交平台的两种评价都缺少可复核方法,不构成选型依据。
· 100 万上下文是能力上限,实际可用长度受费用和延迟约束,跑满很贵。
· 完整权重 11 月 4 日前发布,在那之前只有 API 一条路,本地部署方案还不能评估。
九、事实来源
· 参数量、上下文、Highspeed 版本、权重发布时间、Terminal-Bench 4.0 65.7%、Kimi Code Bench 3.0 61.2%、K3 55.95%、GPT-6 Astra 58.2%、Claude Opus 5.5 66.4%:Kimi 官方文档《Kimi K3.1 Pro》,2026-10-27 抓取
· 三种协议与 base_url、认证方式:Kimi 官方文档《API 概述》,2026-10-27 抓取
· reasoning_effort 三档与默认 max:Kimi 官方文档《推理强度》,2026-10-27 抓取
· K3 上下文 1,048,576、K2 上下文 262,144、K2 停止新注册与下线时间、缓存 TTL 默认 5 分钟、缓存写入单独计费、按量计费无订阅制:Kimi 官方文档《模型推理价格说明》,2026-10-27 抓取
· 后台必填项、协议选择、授权范围三档:官方文档《团队资源配置与分发》,2026-10-27 核对
· 模型价格三项(输入 / 缓存命中输入 / 输出)、缓存命中率指标、「数据总览」口径:官方文档《积分、额度与使用统计》,2026-10-27 核对
· 思考深度低中高、个人模型入口:官方文档《模型配置与使用》,2026-10-27 核对